LTX 2 en MLX — y más allá
Ejecuta LTX 2 MLX
sin tener un Mac de 16GB.
O salta del todo el equipo local.
El puerto MLX llevó LTX 2 a Apple Silicon, y es un trabajo ingenioso — para exactamente una máquina a la vez. Si la memoria unificada de tu Mac no aguanta los pesos y los latentes, o prefieres no congelar un portátil cuarenta minutos por clip, Moosky ejecuta LTX-2.5 alojado en GPUs de centro de datos: cotizado por clip, en cola en la nube, audio nativo en la misma pasada.
Opciones de modelos
Elegí el flujo que mejor se ajusta a tu proyecto
Empezá con un prompt, sumá referencias si hace falta y elegí el camino de generación que coincida con el resultado que buscás.
MLX en tu propio Mac
Si ya tienes un Mac Apple Silicon con memoria unificada de sobra y te gusta trastear, el puerto MLX es una vía legítima para experimentar con LTX 2 en el dispositivo: nada se sube, nada se mide, y el stack de ML de Apple sigue mejorando. Cuando local te conviene, de verdad conviene — eso no es un eslogan, es esta página.
LTX-2.5 alojado en Moosky
En el momento en que tu Mac dice no — pesos y activaciones fuera de la memoria unificada, térmicas estrangulando el render o una entrega que no puede esperar a una máquina — la vía alojada toma la misma calidad de salida y la lleva a GPUs de centro de datos. Resolución, duración y coste por clip se cotizan antes de generar, y la cola sigue andando después de cerrar la pestaña.
Lotes + Project Director
Un ejecutor local es una herramienta de una sola cita: un prompt, un clip, una máquina ardiendo. La forma de la nube es distinta — alinea una semana de clips, variantes y cortes, entrega la secuencia completa a Project Director y recoge escenas terminadas con locución y música mientras tu Mac vuelve a ser solo un Mac.
Créditos por clip, sin suscripción
Un render local no tiene línea de factura, y así esconde su coste: el clip que «salió gratis» gastó cuarenta minutos de un portátil que pagaste a precio completo, y los pesos nuevos siguen llegando a tu curva de ventilador. La vía alojada pone el mismo intercambio a la vista — créditos por clip cotizados antes de generar, que nunca expiran, y un saldo que además cubre cada otro modelo cuando LTX no es la herramienta para un plano.
Ejemplos de resultados
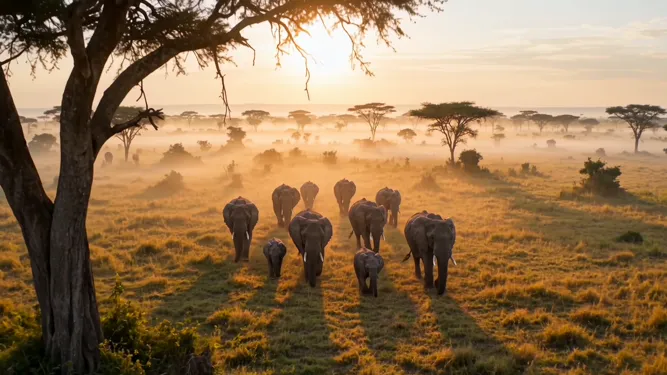
Los mismos pesos, renderizando mientras tu portátil duerme
Resultados reales de LTX-2.5 y Wan 3.0 en las GPUs alojadas de Moosky — sin techo de memoria unificada, sin máquinas rehén.
Por qué usarlo en Moosky AI
Herramientas potentes. Experiencia sin fricción.
Memoria unificada, sin mentiras
Un LTX local necesita que pesos, caché KV y tu SO compartan un solo pool de memoria. Macs de 8 o 16GB se atascan o intercambian disco antes de acabar un clip útil — eso es física, no marketing.
La cola sobrevive a tu tarde
Envía diez variantes a la cola de la nube y los renders siguen mientras el portátil duerme, vuela o renderiza otra cosa. El MLX local te espera a ti y a tus térmicas.
El audio llega en la pasada
El LTX-2.5 alojado devuelve diálogo y ambiente sincronizados con el vídeo, así no hay un segundo proceso local robando margen de GPU para generar sonido.
Coste visible antes de calcular
El composer cotiza el precio exacto en créditos de tu duración, resolución y modelo antes de empezar. El coste oculto del render local — treinta minutos de una máquina que pagaste entera — nunca aparece en una factura.
Cualquier dispositivo, el mismo saldo
Como el render es remoto, el modelo corre igual en un PC con Windows, un Chromebook o el MacBook de 8GB que el puerto MLX rechaza con educación. Una cuenta, un saldo de créditos.
Comercial por defecto
Los clips de la nube se descargan sin marca de agua y están listos para canales monetizados, anuncios y entregas a cliente con cualquier saldo — sin niveles de licencia que desbloquear.
Cómo funciona
Tres pasos para saltarte las cuentas de VRAM
Regístrate, prueba gratis
Las cuentas nuevas arrancan con créditos de registro — suficientes para correr un clip LTX-2.5 de verdad de principio a fin antes de gastar nada ni descargar nada.
Pega el prompt que guardaste
Abre el composer de LTX-2.5 y ejecuta el prompt que ibas a dar a tu Mac. La cotización en créditos aparece primero; el render corre en nuestras GPUs, no en las tuyas.
Recoge y encola el siguiente
El clip llega a tu biblioteca con audio. Alinea las variantes para las que la cola local nunca tuvo tiempo y deja que la nube las devore de un tirón.
Cuándo MLX es la respuesta — y cuándo no lo es en silencio
Un desarrollador de juegos que conocimos intentó despachar renders LTX desde un M1 Air. El puerto MLX cargó, el primer prompt corrió, y el ventilador respondió antes que los fotogramas: la memoria superó lo que la máquina aguantaba, los pesos cuantizados ablandaron la salida, y un render de cuarenta minutos acabó con la jornada del portátil. El puerto no hizo nada mal. El presupuesto de hardware simplemente se agotó.
Esa es la línea de división honesta. Si tienes un Mac con memoria unificada seria, MLX local es un camino real, privado y sin medidor — consérvalo. Si no, la misma familia de modelo ya está corriendo en GPUs de centro de datos en Moosky: LTX-2.5 alojado, cotizado por clip en créditos, audio nativo en la misma pasada, descargas sin marca de agua.
Y la nube compra algo que un portátil nunca puede: la cola. Envía una semana de variantes, entrega una secuencia a Project Director, y los renders siguen mientras tu dispositivo hace cosas de dispositivo. Empieza con un clip de prueba con créditos de registro y deja que los dos archivos decidan.
Créditos
Precio simple y honesto
Sin suscripciones. Sin costos ocultos. Pagás solo los créditos que usás.

Más de Moosky AI
Explorá toda la suite de herramientas de IA.
Preguntas frecuentes
¿Puedo ejecutar LTX 2 MLX en un Mac de 16GB?
A veces, justo, y esa es la respuesta honesta. El puerto MLX mantiene el modelo residente en la memoria unificada, y la generación de vídeo también necesita memoria para latentes, cachés y el SO. Con 8GB está fuera de alcance; con 16GB muchas ejecuciones se atascan, intercambian o fuerzan una cuantización agresiva que cuesta justo la calidad por la que viniste. Los Mac con 24–64GB de memoria unificada sí tienen una oportunidad real de ejecutarlo local.
¿Ejecutar LTX 2 local es mejor que un servicio en la nube?
Puede serlo, y lo diremos cuando lo sea: si ya tienes un Mac Apple Silicon de mucha memoria, quieres privacidad total y disfrutas manteniendo tu propio stack, un ejecutor local no te cuesta nada por clip y mantiene cada fotograma en tu máquina. Pierde cuando te falta memoria, no puedes tener un portátil ocupado un render entero, necesitas lotes o variantes, o quieres los pesos nuevos sin perseguir el próximo release de un repo comunitario.
¿Cuánto cuesta por clip la vía alojada de Moosky?
Los créditos son 100 por dólar y nunca expiran, y el composer cotiza el coste exacto de tu clip — duración, resolución, modelo — antes de que pulses generar. No hay suscripción que cancelar ni coste por máquina ociosa: pagas los renders que pides, una cuenta que una GPU local nunca iguala del todo cuando le pones precio al hardware.
¿LTX-2.5 alojado es el mismo modelo que el puerto MLX?
La misma familia de modelo, distinta generación. El puerto MLX sigue los releases de pesos abiertos que caben en Apple Silicon; Moosky sirve LTX-2.5 alojado, la cima actual de esa familia, en GPUs de centro de datos — además de ajustes de borrador rápidos y el resto del catálogo de vídeo en un solo saldo, así que un borrador barato y una pasada final son los mismos dos clics.
¿Por qué los renders siguen cuando cierro la pestaña?
Porque nada renderiza en tu dispositivo. Los prompts viajan a la cola de Moosky, las GPUs de allí hacen el trabajo, y los clips terminados con audio te esperan en tu biblioteca. Eso es justo lo que hace posible el trabajo por lotes: lanza diez variantes, vuelve con diez resultados, y tu Mac pasó todo ese tiempo siendo otra vez una máquina de escribir.
Divulgación
Moosky AI es una plataforma independiente y revendedora de acceso a modelos de IA. Los nombres de productos, modelos y empresas que aparecen en esta página pertenecen a sus respectivos titulares. Moosky AI no está oficialmente afiliada, patrocinada ni avalada por esos proveedores salvo que se indique expresamente. El contenido de la página, los ejemplos y las previsualizaciones pueden incluir contenido asistido por IA y sintético.