LTX 2 no MLX — e além dele
Rode LTX 2 MLX
sem ter um Mac de 16GB.
Ou pule de vez o rig local.
O port MLX levou o LTX 2 ao Apple Silicon, e é um trabalho genuinamente esperto — para exatamente uma máquina por vez. Se a memória unificada do seu Mac não segura os pesos e os latentes, ou você prefere não congelar um laptop por quarenta minutos por clipe, o Moosky roda o LTX-2.5 hospedado em GPUs de datacenter: cotado por clipe, na fila da nuvem, áudio nativo na mesma passada.
Opções de modelos
Escolha o fluxo que combina com a sua cena
Comece com um prompt, adicione referências quando precisar e escolha o caminho de geração que corresponda ao resultado.
MLX no seu próprio Mac
Se você já tem um Mac Apple Silicon com memória unificada de sobra e gosta de fuçar, o port MLX é um caminho legítimo para experimentar o LTX 2 no dispositivo: nada sobe, nada é medido, e o stack de ML da Apple segue melhorando. Quando local te serve, serve mesmo — isso não é frase de marketing, é a página.
LTX-2.5 hospedado no Moosky
No momento em que o Mac diz não — pesos e ativações fora da memória unificada, térmicas estrangulando o render ou um prazo que não pode esperar uma máquina — o caminho hospedado pega a mesma qualidade de saída e leva para GPUs de datacenter. Resolução, duração e custo por clipe são cotados antes de gerar, e a fila continua depois que você fecha a aba.
Lote + Project Director
Um executor local é uma ferramenta de encontro único: um prompt, um clipe, uma máquina pegando fogo. O formato da nuvem é outro — alinhe uma semana de clipes, variantes e cortes, entregue a sequência inteira ao Project Director e colete cenas prontas com locução e música enquanto seu Mac volta a ser só um Mac.
Créditos por clipe, sem assinatura
Um render local não tem linha de fatura, e é assim que esconde o custo: o clipe que «saiu de graça» gastou quarenta minutos de um laptop que você pagou inteiro, e os pesos novos seguem chegando à sua curva de ventoinha. O caminho hospedado põe a mesma troca às claras — créditos por clipe cotados antes de gerar, que nunca expiram, e um saldo que também cobre todo o resto quando o LTX não é a ferramenta para um plano.
Exemplos de resultados
Os mesmos pesos, renderizando enquanto seu laptop dorme
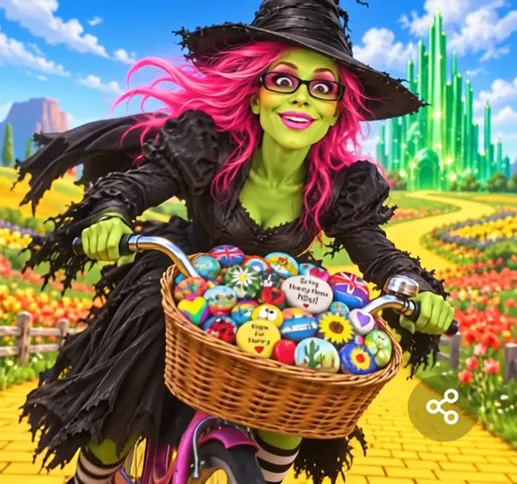
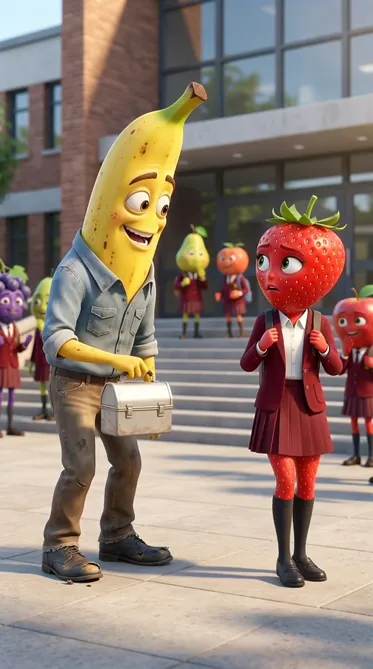
Resultados reais de LTX-2.5 e Wan 3.0 nas GPUs hospedadas do Moosky — sem teto de memória unificada, nenhuma máquina refém.
Por que usar no Moosky AI
Ferramentas poderosas. Experiência sem atrito.
Memória unificada, sem papo
Um LTX local precisa dividir pesos, cache KV e o seu SO num único pool de memória. Macs de 8 ou 16GB engasgam ou trocam disco muito antes de um clipe útil terminar — isso é física, não marketing.
A fila sobrevive à sua tarde
Mande dez variantes para a fila da nuvem e os renders continuam enquanto o laptop dorme, voa ou renderiza outra coisa. O MLX local espera por você e pelas suas térmicas.
O áudio vem na passada
O LTX-2.5 hospedado devolve diálogo e ambiência sincronizados com o vídeo, então não existe um segundo processo local roubando folga de GPU para gerar som.
Custo antes de calcular
O composer cotiza o preço exato em créditos da sua duração, resolução e modelo antes de começar. O custo escondido do render local — trinta minutos de uma máquina que você pagou inteira — nunca aparece numa fatura.
Qualquer dispositivo, mesmo saldo
Como o render é remoto, o modelo roda igual num PC Windows, num Chromebook ou no MacBook de 8GB que o port MLX recusa educadamente. Uma conta, um saldo de créditos.
Comercial por padrão
Os clipes da nuvem baixam sem marca d'água e estão liberados para canais monetizados, anúncios e entregas de cliente em qualquer tamanho de saldo — sem nível de licença para desbloquear.
Como funciona
Três passos para pular a conta de VRAM
Cadastre-se, teste grátis
Contas novas começam com créditos de cadastro — o bastante para rodar um clipe LTX-2.5 de verdade de ponta a ponta antes de gastar qualquer coisa ou baixar qualquer coisa.
Cole o prompt que você guardou
Abra o composer do LTX-2.5 e rode o prompt que você ia dar ao seu Mac. A cotação em créditos aparece primeiro; o render roda nas nossas GPUs, não nas suas.
Colha e enfileire o próximo
O clipe chega na sua biblioteca com áudio. Alinhe as variantes para as quais a fila local nunca teve tempo e deixe a nuvem devorar tudo de uma vez.
Quando MLX é a resposta — e quando ele silenciosamente não é
Um desenvolvedor de jogos que conhecemos tentou despachar renders LTX de um M1 Air. O port MLX carregou, o primeiro prompt rodou, e a ventoinha respondeu antes dos quadros: a memória estourou o que a máquina segurava, os pesos quantizados amoleceram a saída, e um render de quarenta minutos encerrou o dia do laptop. O port não fez nada errado. O orçamento de hardware simplesmente acabou.
Essa é a linha de divisão honesta. Se você tem um Mac com memória unificada séria, MLX local é um caminho real, privado e sem medidor — fique com ele. Se não, a mesma família de modelo já está rodando em GPUs de datacenter no Moosky: LTX-2.5 hospedado, cotado por clipe em créditos, áudio nativo na mesma passada, downloads sem marca d'água.
E a nuvem compra algo que um laptop nunca pode: a fila. Envie uma semana de variantes, entregue uma sequência ao Project Director, e os renders continuam enquanto seu dispositivo faz coisas de dispositivo. Comece com um clipe de teste dos créditos de cadastro e deixe os dois arquivos decidirem.
Cobrança por créditos
Preço simples e transparente
Sem assinaturas. Sem taxas escondidas. Pague apenas pelos créditos que usar.

Mais da Moosky AI
Conheça a suíte completa de ferramentas de IA.
Perguntas frequentes
Consigo rodar LTX 2 MLX num Mac de 16GB?
Às vezes, no talo, e essa é a resposta honesta. O port MLX mantém o modelo residente na memória unificada, e a geração de vídeo também precisa de memória para latentes, caches e o SO. Com 8GB está fora de alcance; com 16GB muitas execuções engasgam, trocam disco ou forçam uma quantização agressiva que custa exatamente a qualidade que você veio buscar. Macs com 24–64GB de memória unificada têm uma chance real de rodar local.
Rodar LTX 2 local é melhor que um serviço em nuvem?
Pode ser, e a gente diz quando é: se você já tem um Mac Apple Silicon de muita memória, quer privacidade total e curte manter o próprio stack, um executor local não custa nada por clipe e mantém cada quadro na sua máquina. Ele perde quando falta memória, você não pode deixar um laptop ocupado um render inteiro, precisa de lotes ou variantes, ou quer os pesos novos sem caçar o próximo release de um repo da comunidade.
Quanto custa por clipe a rota hospedada do Moosky?
Os créditos são 100 por dólar e nunca expiram, e o composer cotiza o custo exato do seu clipe — duração, resolução, modelo — antes de você apertar gerar. Não há assinatura para cancelar nem custo de máquina ociosa: você paga os renders que pede, uma conta que uma GPU local nunca fecha igual depois de precificar o hardware.
O LTX-2.5 hospedado é o mesmo modelo do port MLX?
Mesma família de modelo, geração diferente. O port MLX acompanha os releases de pesos abertos que cabem no Apple Silicon; o Moosky serve o LTX-2.5 hospedado, o topo atual dessa família, em GPUs de datacenter — além de ajustes de rascunho rápidos e o resto da lineup de vídeo num único saldo, então um rascunho barato e uma passada final são os mesmos dois cliques.
Por que os renders continuam quando fecho a aba?
Porque nada renderiza no seu dispositivo. Os prompts vão para a fila do Moosky, as GPUs de lá fazem o trabalho, e os clipes prontos com áudio esperam na sua biblioteca. Isso é também o que torna o lote possível: comece dez variantes, volte com dez resultados, e seu Mac passou o tempo todo sendo de novo uma máquina de escrever.
Divulgação
A Moosky AI é uma plataforma independente e revendedora de acesso a modelos de IA. Os nomes de produtos, modelos e empresas exibidos nesta página pertencem aos respectivos titulares. A Moosky AI não é oficialmente afiliada, patrocinada nem endossada por esses provedores, salvo quando indicado expressamente. O conteúdo da página, os exemplos e as pré-visualizações podem incluir conteúdo assistido por IA e sintético.