La interfaz de la app está en inglés por ahora.
Guía de campo de Moosky AI
Cómo crear un prompt de video con IA a partir de un clip que ya te gusta
Guía en español para crear un prompt de video con IA a partir de un clip: la pasada de lectura en cinco casillas, el atajo r2v y la iteración por cláusula.
En esta página
Cómo crear un prompt de video con IA a partir de un clip que ya te gusta
Estás scrolleando y un clip te frena: ese plano de un patinador entrando al bowl al atardecer, la tabla girando abajo, la cámara quieta mientras todo se mueve. Apretás generar y escribís «patinador épico con estilo cinematográfico». Te devuelve un figurín posando bajo luz de cumpleaños. El problema no es tu gusto; es que le pediste al modelo que adivinara un plano que vos ya tenías visto. La salida es invertir el proceso: tratar el clip como un documento, leerlo en cinco casillas, y dejar que el prompt se arme solo.
Esta guía es el flujo inverso en español — del video al prompt — sobre Moosky: cómo observar un clip de referencia como lo haría un montajista, convertir las anotaciones en un prompt que los modelos respetan, cuándo saltarte media escritura y adjuntar el clip entero en Wan 3.0 R2V o MiniMax H3, y cómo iterar leyendo la diferencia entre lo que pediste y lo que salió.
Si tu punto de partida es una idea en la cabeza y necesitás el primer prompt desde cero, eso es otro camino: la guía paso a paso para hacer un video con IA cubre el sentido directo, del plan al render. Acá importa el otro: primero el clip, después las palabras.
La pasada de lectura: cinco casillas
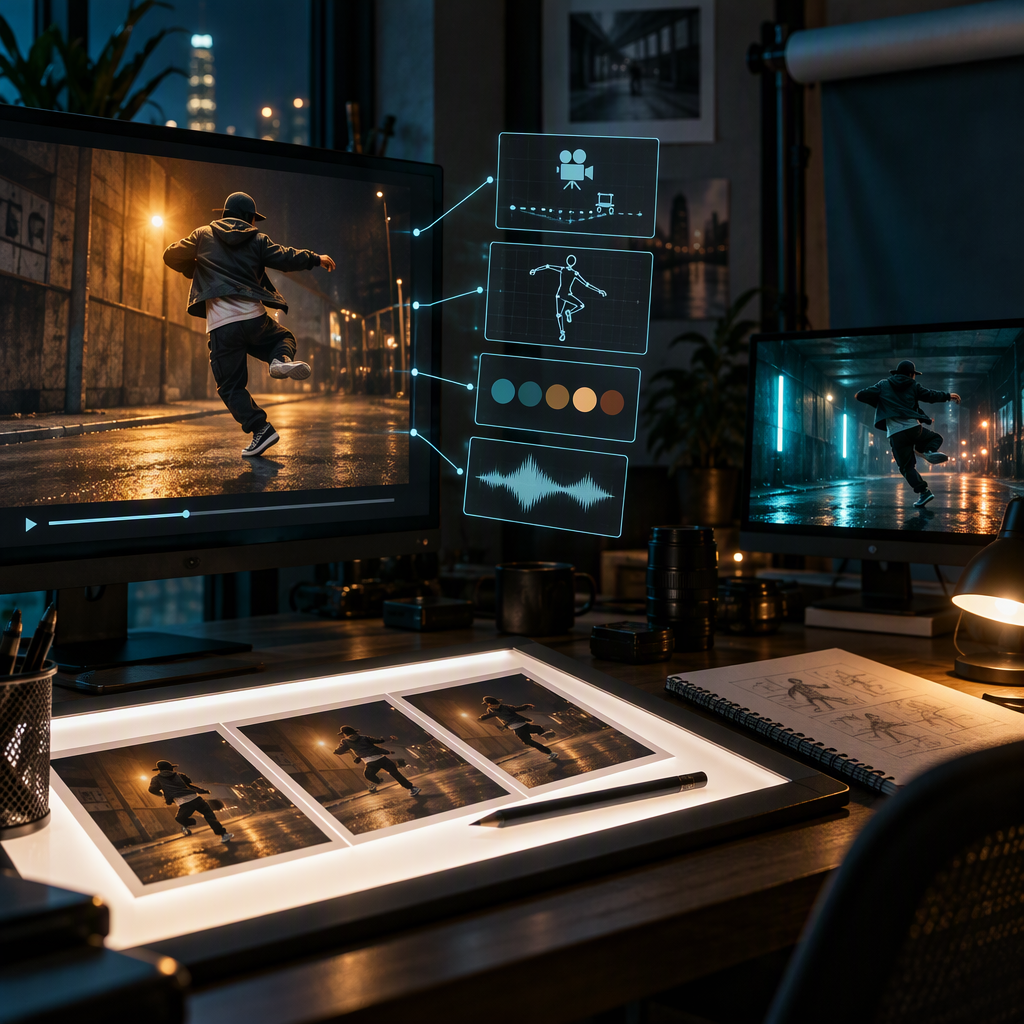
Mirá el clip tres veces con una libreta abierta. La primera por contenido, la segunda por la cámara, la tercera por la textura. Completá estas cinco casillas con la escena del patinador como ejemplo:
- Sujeto. Quién o qué está en cuadro, y cuántos. Sustantivos concretos, no adjetivos: «un pibe con gorra y camisa holgada», no «una figura urbana». Si el sujeto gira, fijate qué perfil tiene: ese detalle te va a servir después, cuando quieras atar su identidad con una referencia.
- Acción. Lo único que cambia a lo largo del clip, dicho como movimiento. «Embebe antes del borde, salta y la tabla da una vuelta bajo los pies» es una acción; «patinando» es una foto estática con trámite extra.
- Escenario. Lugar y hora del día, una sola cláusula. Anotá lo que hace específico el lugar —el cemento agrietado del bowl, la luz rasada de las siete— y olvidate del relleno que el renderador completa igual.
- Cámara. Tamaño de plano (close, medio, abierto), ángulo (picado, contrapicado, a nivel), y movimiento (avance lento, paneo, cámara en mano, fija). Esta es la casilla que todo el mundo saltea y la que separa un render de IA de un plano filmado. Congelá el primer y el último cuadro del clip: si el fondo corre respecto del sujeto, la cámara viajó; si el sujeto se mueve sobre un fondo clavado, no.
- Estilo. Un único cluster coherente de luz, paleta y textura: «hora azul, neones teal, grano 35mm» es un cluster. Cinco palabras de estilo sueltas son la receta del resultado sopa.
Del cuaderno al prompt
Reordená las anotaciones en el orden de lectura del modelo: sujeto y acción primero (se llevan el presupuesto de atención), la cámara como tercera cláusula, el estilo al final. Nombrá el verbo de movimiento aunque te parezca obvio —y si el clip no se mueve, escribí «cámara fija» explícito—, porque si no lo decís, el motor puede inventar un deriva que no estaba en tu referencia.
Después tradujé lo que viste con los ojos al vocabulario que los motores entienden de verdad: avance, retroceso, órbita, paneo, tilt, seguimiento, ascenso de dron, cámara en mano. Los modelos insignia que corre Moosky responden mucho mejor al vocabulario de rodaje que a los adjetivos de ánimo: Wan 3.0 cuando el plano es movimiento, MiniMax H3 cuando es diálogo, Seedance 2.5 y LTX 2.5 en el término medio. La diferencia entre «se mueve la cámara» y «avance lento» se mide con el cuadro congelado: ¿el sujeto creció o el fondo se corrió?
Si tenés un chat con visión abierto en otra pestaña, mandale fotogramas y pedile descripciones —pero la parte de escritura sigue siendo tuya: las cinco casillas son lo que convierte sus párrafos en un prompt utilizable en vez de una caption florida.
El atajo: adjuntá el clip y escribí solo el cambio
Las palabras son un canal. Los dos composers de referencia de Moosky también aceptan el clip, y una referencia hace tu descripción por vos.
Wan 3.0 R2V recibe hasta 10 imágenes de referencia, 5 videos de referencia (15 segundos sumados, y los segundos del clip de entrada salen del mismo presupuesto de 30 que la salida) y 5 audios sueltos por corrida. Adjuntá el clip que trae el movimiento y el ritmo que querés, y en el prompt escribí únicamente lo que cambia: el sujeto nuevo, el escenario nuevo. El orden de subida es significado —el primer video es el Video 1— y el prompt llama a cada material con ese rótulo, así la referencia de movimiento se cita, no se insinúa. La guía r2v en español te deja los techos y la trampa de los 30 segundos resueltos; el hub de referencia para video muestra la línea completa en vivo.
MiniMax H3 Ref2V es la misma idea afinada para la toma hablada: 9 imágenes, 3 clips de video, 3 audios, el diálogo citado se actúa con labios sincronizados, duración de 4 a 15 segundos, borradores en 768P (la línea publicada gira en torno a 10 créditos por segundo) y finales en 2K, con las corridas fallidas reintegradas. Pasá el clip como Video 1 y escribí la escena nueva alrededor — el flujo H3 Ref2V paso a paso recorre la hoja entera.
La práctica se parte así: extracción a palabras cuando querés remezclar el plano (sujeto nuevo, lugar nuevo, misma sensación); adjuntar el clip cuando querés reemplazar algo dentro de esa misma sensación exacta. La mayoría sobre-escribe prompts para el segundo trabajo; el clip ya es la frase corta.
Entrá directo a las superficies: la página de Wan con IA para video, el composer Wan 3.0 R2V y el composer de MiniMax H3. Como todo en Moosky, corren con créditos (100 = US$ 1), el composer te muestra el costo exacto antes de apretar generar, y las corridas fallidas se reintegran.
El bucle de iteración: leer la brecha, tocar una cláusula
Compará el render contra el cuadro de referencia, cuadro por cuadro, y diagnosticá por casilla:
| Qué se corrió | La cláusula que falló | La corrección |
|---|---|---|
| La cámara no se mueve (o vaga sola) | Cámara | Nombrá el verbo y la velocidad: «avance lento», «seguimiento en mano», o escribí «fija» |
| El clima está, el plano es genérico | Escenario/sujeto | Sumá el único detalle concreto que hacía única la referencia; sacá las palabras de ánimo |
| Cuadro hermoso, actuación muerta | Acción | Tu verbo describía un estado, no un cambio — reescribilo como lo que se mueve |
| El estilo pelea con el sujeto | Estilo | Dejá un solo cluster, movelo al final, cortá el resto |
| La identidad cambia entre tomas | No es problema del prompt | Atá una referencia de identidad en vez de describir más fuerte: para eso está el slot r2v |
Cambiá una cláusula por re-tiro y generá barato primero (borradores en el escalón bajo — en 480P una toma de cinco segundos sale en la zona de los 39 créditos, y el número exacto lo muestra el composer), y escalá a finales solo para las tomas que entran. Re-tirar al azar compara una conjetura contra una monedita; editar cláusulas compara una hipótesis contra evidencia.
Lo que la lectura no traduce
Hay planos que no sobreviven la traducción a texto: un temblor de mano específico, el ritmo de montaje, un avance que acelera al final. Esos viven en los píxeles, y por eso existe la vía del clip adjunto —escribí con palabras lo estable y citá lo inestable pegando la referencia—. Dos límites de la familia de motores, claros antes de armar la escena: el texto literal en pantalla no es confiable (no diseñes un plano en torno a un cartel legible), y el diálogo citado se reproduce tal cual pero sin promesa de labios cuadro-perfectos a una sílaba exacta. Si tu entrega depende de eso, pagá un borrador y verificá antes de comprometerte.
Cuando el prompt y la referencia cargan cada uno con lo suyo, dejás de pelear con el modelo por cosas que nunca estuvo en condiciones de escuchar. La guía EN hermana, video to prompt, trabaja el mismo flujo con su propia escena; y si lo que necesitás es montar varias tomas seguidas desde un guion, seguí por el paso a paso del video con IA.
Crea con Moosky AI
Convierte ideas en producciones terminadas
Accede a los principales modelos de IA y flujos de producción desde un solo espacio de trabajo.
Prueba Moosky AIComments
Comments are reviewed before they appear publicly.
Join the discussion — sign in or create an account to leave a comment.
No approved comments yet. Start the conversation.