Generador de video IA Wan 3.0
Video cinematográfico de 30 segundos con Wan 3.0
Wan 3.0 en Moosky: texto-a-video, primeros y últimos fotogramas opcionales, o referencia-a-video por defecto con audio independiente. Sonido nativo, 2–30 segundos, 480P a 1080P.
Opciones de modelos
Elegí el flujo que mejor se ajusta a tu proyecto
Empezá con un prompt, sumá referencias si hace falta y elegí el camino de generación que coincida con el resultado que buscás.
Wan 3.0 (T2V / FFLF)
Texto-a-video sin fotogramas, o primeros y últimos fotogramas opcionales para cámara cinematográfica e interpolación. No se pueden mezclar fotogramas con medios de referencia.
Wan 3.0 (R2V)
Referencia-a-video por defecto para consistencia de personaje, utilería, espacio y estilo. Etiqueta Image 1, Video 1 y Audio 1 en el prompt. Sin ruta de primer fotograma.
Ejemplos de resultados
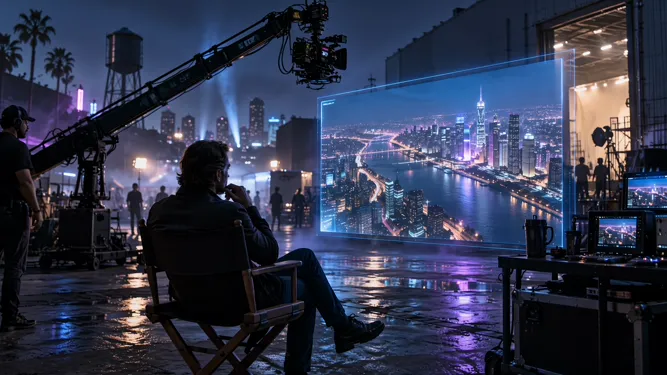
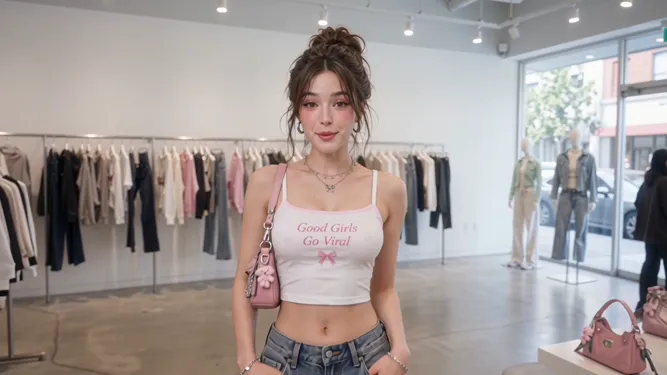
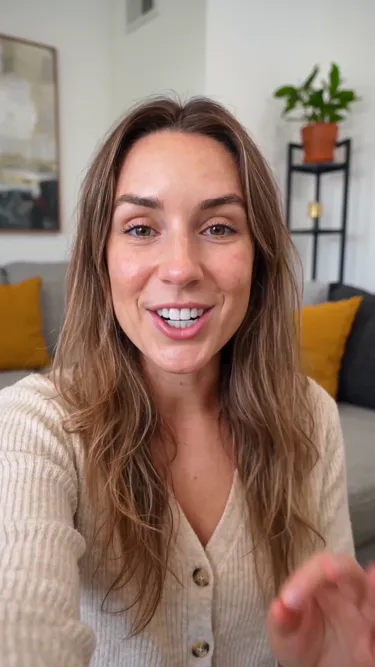
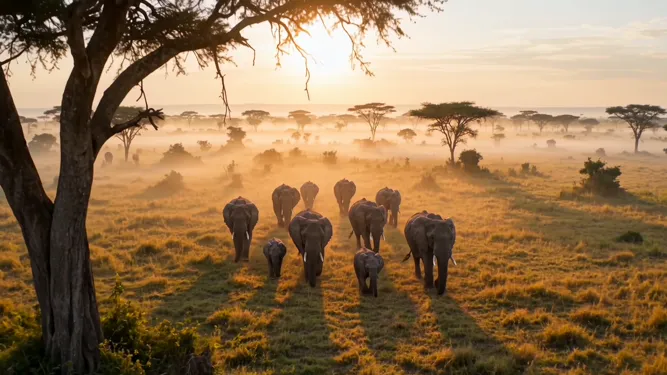
Ejemplos de salidas
Clips públicos destacados creados con Wan 3.0 en Moosky.
Por qué usarlo en Moosky AI
Herramientas potentes. Experiencia sin fricción.
Tomas únicas de 30 segundos
Genera hasta 30 segundos en una pasada para ritmo narrativo y lenguaje de cámara continuo.
Control de primer/último fotograma
Fija la imagen inicial y luego interpola opcionalmente hacia un último fotograma cuando la composición final importa.
Verdadero texto-a-video
Empieza solo con un prompt, o añade fotogramas cuando necesites continuidad visual.
Referencia-a-video por defecto
R2V es el modo por defecto en Moosky para clips con identidad consistente desde referencias de imagen, video y audio independiente.
Audio nativo
El audio de salida opcional viene activado por defecto — diálogo, Foley y música en la misma generación. El lip-sync exacto todavía está madurando.
480P a 1080P
Horizontal, vertical o cuadrado a 480P, 720P o 1080P. Prefiere Wan 3.0 cuando un clip de 16–30 segundos también necesite 1080P.
Cómo funciona
Tres pasos simples hasta el resultado final
Elige un modo
Texto-a-video, primeros/últimos fotogramas opcionales, o R2V con referencias Image 1 / Video 1 / Audio 1.
Fija longitud y tamaño
Elige 2–30 segundos y 480P, 720P o 1080P. El coste en créditos se actualiza antes de enviar.
Genera y revisa
Renderiza el clip, previsualízalo en tu cola y descarga el video final.
Créditos
Precio simple y honesto
Wan 3.0 usa créditos de Moosky con coste variable según la duración y la resolución. Activar o desactivar el audio no cambia la estimación. Revisa el coste antes de generar.

Más de Moosky AI
Explorá toda la suite de herramientas de IA.
Preguntas frecuentes
¿Wan 3.0 requiere imágenes?
No. Wan 3.0 T2V / FFLF puede generar solo desde texto, desde un fotograma inicial, o desde primeros y últimos fotogramas. R2V usa referencias de imagen, video y/o audio en vez de un primer fotograma.
¿Qué es FFLF?
FFLF significa primer-fotograma/último-fotograma. Proporciona una imagen inicial y una imagen final opcional para que el modelo interpole el movimiento entre ellas. Último fotograma sin fotograma inicial es inválido, y los fotogramas no se pueden mezclar con los medios de referencia de R2V.
¿Cuál es la diferencia entre Wan 3.0 FFLF y R2V?
FFLF es texto-a-video o imagen-a-video con interpolación opcional de primer/último fotograma para control de cámara y movimiento. R2V es la ruta de referencia-a-video por defecto: hasta 10 imágenes, 5 videos y 5 archivos de audio independientes, etiquetados Image 1 / Video 1 / Audio 1 en el prompt. R2V no tiene control de primer fotograma.
¿Cuándo debo elegir Wan 3.0?
Elige Wan 3.0 para clips de 16–30 segundos, control de primer/último fotograma, trabajos en 1080P de más de 15 segundos, lenguaje de cámara cinematográfico, o R2V por defecto con personaje consistente. LTX sigue siendo más barato para talking heads cortos. MiniMax H3 es la opción R2V/edición económica para diálogo de ≤15 s. Seedance 2.0 es la alternativa premium de acción cinética.
¿Qué duración y resolución soporta Wan 3.0?
Wan 3.0 soporta videos de 2–30 segundos a 480P, 720P o 1080P en horizontal, vertical o cuadrado.
¿Wan 3.0 genera audio?
Sí. El audio de salida nativo viene activado por defecto y no cambia la estimación en créditos. Cita el diálogo exactamente, o escribe «Sin diálogo». El lip-sync exacto a palabras concretas y el texto en pantalla todavía están madurando.
¿Cuándo debo usar Wan 3.0 R2V?
Usa Wan 3.0 R2V predeterminado para escenas con personaje consistente, diálogo multi-personaje, identidad fotorrealista y referencias de voz Audio 1…5 independientes. No es un especialista en persecuciones/peleas — elige Seedance 2.0 R2V para acción cinética pesada, o MiniMax H3 cuando necesites una edición ≤15 s más barata.