Wan 3.0 R2V (Referencia a Video)
Generador Wan 3.0 R2V:
Referencias entran.
Movimiento se conserva.
R2V es el modo de referencias de Wan 3.0: entrégale tus caras y tu estilo como imágenes, el movimiento que quieres como clips de video, y voces opcionales como audio — y Wan reinterpreta una escena totalmente nueva que conserva el movimiento, los personajes y la sincronía. Sin suscripción, pagas por clip con créditos.
Opciones de modelos
Elegí el flujo que mejor se ajusta a tu proyecto
Empezá con un prompt, sumá referencias si hace falta y elegí el camino de generación que coincida con el resultado que buscás.
Wan 3.0 (R2V)
El modo referencia-a-video por defecto de Wan 3.0, expuesto en Moosky como el compositor R2V. Aliméntalo con un kit de referencias — fotos fijas de caras y vestuario, tableros de estilo, clips de movimiento, tomas de voz — etiqueta cada archivo en el prompt, y Wan conserva la identidad, el estilo y el movimiento mientras interpreta tu escena nueva con audio nativo.
Other reference-to-video models
R2V es uno de los tres modos de referencia en Moosky. Cuando una toma vive o muere por el diálogo hablado, MiniMax H3 Ref2V es el carril de diálogo; cuando es acción cinética pesada, Seedance 2.0 R2V lo maneja mejor. La línea completa está en el hub de referencia-to-video.
Ejemplos de resultados
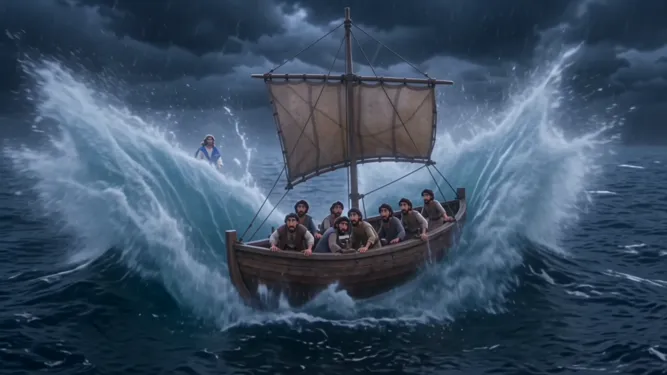
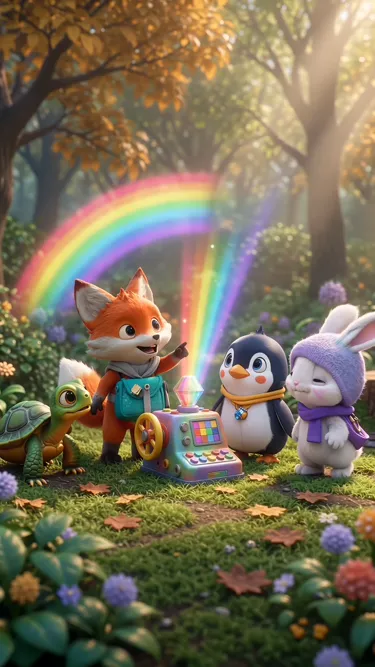
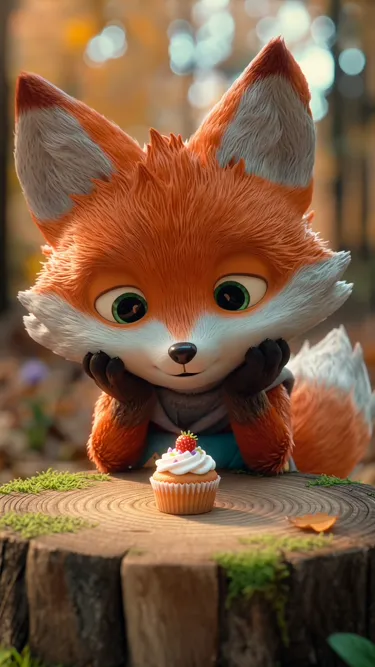
Clips renderizados en el modo R2V de Wan 3.0
Salidas reales de generación condicionada por referencias con audio nativo en Moosky.
Por qué usarlo en Moosky AI
Herramientas potentes. Experiencia sin fricción.
Renders condicionados por referencias
Pásale al modelo archivos de referencia en vez de re-describir a tu personaje en cada prompt. La identidad vive en tus subidas, no en tu redacción, así la toma nueve se parece a la toma uno.
Movimiento desde un clip de referencia
Sube un video corto del movimiento que quieres — un loop de baile, una combinación de pelea, un ciclo de caminata — y Wan re-esceniza ese movimiento en tu personaje dentro de una escena nueva.
Looks anime y estilizados
Fija planos de color plano, grosor de línea y paleta con referencias de imagen de tablero de estilo, así el look sobrevive al movimiento en vez de derivar hacia el fotorrealismo.
Referencias de voz independientes
Adjunta hasta cinco tomas de audio como referencias y la línea interpretada mantiene ese timbre a lo largo del clip — el audio puede acompañar imágenes o video.
Audio nativo en la misma pasada
El audio de salida va activado por defecto: diálogo, Foley y ambiente se renderizan con la imagen. El lip-sync exacto a palabras concretas todavía está madurando.
Pagas por clip
R2V corre con créditos de Moosky (100 por $1). El compositor cotiza el coste exacto a partir de la longitud y la resolución de tu clip antes de que nada se ejecute.
Cómo funciona
Tres pasos simples hasta el resultado final
Carga el kit de referencias
Sube caras y fotos fijas de vestuario, un tablero de estilo, el clip de movimiento que quieres igualar y tomas de voz opcionales — en orden, porque las etiquetas siguen el orden.
Etiqueta y dirige la escena
Prompte la toma nueva — escenario, acción, cámara, diálogo — y referencia cada archivo por su etiqueta (Image 1, Video 1, Audio 1) para que su rol sea explícito.
Renderiza movimiento + audio
Elige 2-30 segundos a 480P, 720P o 1080P y genera — el clip llega a tu cola con su pista de audio nativa.
Por qué Wan 3.0 R2V para dirección por referencias con movimiento consistente
El fallo en el que cae todo clip IA con mucho movimiento no es la cara, es el movimiento. Pide «un breakdancer gira en un flare» en texto plano y obtienes el movimiento que el modelo inventa, que cambia en cada re-roll. R2V es la respuesta de Wan 3.0: los videos de referencia llevan el movimiento. Sube un clip del movimiento real, un loop de baile, una combinación de pelea, una caminata ensayada, y Wan condiciona el render sobre él, re-escenizando ese movimiento en una escena nueva con tu personaje. El prompt escribe el escenario y la cámara; el archivo de referencia escribe la coreografía. Una toma desviada entonces cuesta un cambio de archivo, no un párrafo de cirugía de prompt: cuando el puñetazo parece un empujón, carga una referencia de movimiento más limpia y re-ejecuta, y los borradores cortos en 480P siguen siendo tan baratos que puedes esbozar una secuencia entera antes de comprometer una toma heroica a 1080P.
Para trabajo anime y estilizado el mismo principio fija el look. Un clip cel-shaded vive o muere por el grosor de línea, la paleta y cómo se mueven pelo y tela, detalles que un párrafo de prompt solo puede aproximar. Carga tres o cuatro fotogramas terminados de tu personaje como referencias de imagen y un clip corto del movimiento que quieres, y el render conserva el estilizado a lo largo del movimiento en vez de solo el primer fotograma. Eso es transferencia de movimiento en la práctica: el gesto sobrevive desde tu referencia hasta la toma, y el personaje sobrevive de toma en toma.
La disciplina de etiquetado es lo que hace funcionar el kit. Cada archivo toma su rol de cómo lo nombras en el prompt: Image 1 la cara, Image 2 el atuendo, Video 1 el movimiento de cámara, Video 2 la coreografía, Audio 1 la voz. Los roles explícitos dejan que una escena multi-personaje lleve un kit de referencias por rol en una sola generación. Y R2V no tiene ruta de primer fotograma; cuando necesitas la imagen inicial fija, eso es el modo FFLF en la página del generador Wan 3.0.
Créditos
Precio simple y honesto
Sin suscripciones. Sin costos ocultos. Pagás solo los créditos que usás.

Más de Moosky AI
Explorá toda la suite de herramientas de IA.
Preguntas frecuentes
¿Qué es Wan 3.0 R2V?
R2V es el modo referencia-a-video de Wan 3.0: en lugar de solo un prompt, la generación se condiciona con archivos que tú aportas — hasta 10 imágenes, 5 videos y 5 clips de audio independientes. Las imágenes llevan caras, vestuario y estilo; los videos llevan el movimiento; el audio lleva la voz. Wan interpreta tu escena nueva manteniendo todo eso consistente, con audio de salida nativo en la misma pasada.
¿Puedo transferir movimiento de un video a otro personaje?
Es el caso de uso de transferencia de movimiento para el que R2V está construido. Sube un clip del movimiento (1-15 segundos, y todos tus videos de referencia por debajo de 15 s) como referencia de Video, describe tu personaje y escenario, y etiqueta los roles (Image 1 es la cara, Video 1 es el movimiento). Wan re-esceniza ese movimiento en tu sujeto en vez de inventar el suyo, recortando para que entrada más clip no pasen de 30 s. Para persecuciones o peleas donde la acción es la toma, Seedance 2.0 R2V maneja cinéticas más pesadas.
¿En qué se diferencia R2V del control de primer/último fotograma?
Primer/último fotograma (FFLF) fija la imagen inicial e interpola opcionalmente hasta una imagen final — controla composición y cámara entre dos fotogramas. R2V reemplaza por completo la ruta de primer fotograma: tú condicionas con referencias de identidad, estilo, movimiento y voz, y no puedes mezclar medios de referencia con fotogramas. Ambos modos renderizan 2-30 segundos a hasta 1080P con audio nativo; en R2V, los clips que usan una referencia de video se ajustan para que entrada y salida queden dentro de 30 segundos.
¿Funciona R2V para anime y animación estilizada?
Sí — es el modo para eso. El trabajo estilizado depende del grosor de línea, los planos de color plano y cómo se mueven pelo y tela, cosas que un prompt aproxima mal. Carga un tablero de estilo de tres o cuatro fotogramas terminados como referencias de imagen más un clip de movimiento, y el look se mantiene a lo largo del movimiento y no solo en el primer fotograma. El flujo de poses clave (fotogramas inicial y final) vive en el modo FFLF de la página de Wan 3.0.
¿Cómo controlo qué hace cada archivo de referencia?
Ordena las subidas a propósito y etiquétalas en el prompt: Image 1 la cara, Image 2 el vestuario, Image 3 el tablero de estilo, Video 1 el movimiento de cámara, Video 2 la coreografía, Audio 1 la voz. Wan lee esas etiquetas y asigna a cada archivo su rol, así es como una escena multi-personaje puede llevar un kit de referencias por rol en un solo trabajo.
¿Cuánto cuesta Wan 3.0 R2V en Moosky?
Las generaciones se facturan en créditos (100 créditos por $1), con el coste siguiendo la duración y la resolución — 480P, 720P o 1080P entre 2 y 30 segundos (una referencia de video recorta la salida máxima para que entrada más clip queden dentro de 30 s). Activar o desactivar el audio no cambia la estimación. El compositor cotiza el coste exacto a partir de la longitud y la resolución de tu clip antes de que envíes, y las ejecuciones fallidas se devuelven. No se requiere suscripción.
Divulgación
Moosky AI es una plataforma independiente y revendedora de acceso a modelos de IA. Los nombres de productos, modelos y empresas que aparecen en esta página pertenecen a sus respectivos titulares. Moosky AI no está oficialmente afiliada, patrocinada ni avalada por esos proveedores salvo que se indique expresamente. El contenido de la página, los ejemplos y las previsualizaciones pueden incluir contenido asistido por IA y sintético.