Wan 3.0 R2V (Referência para Vídeo)
Gerador Wan 3.0 R2V:
Referências entram.
Movimento se mantém.
R2V é o modo de referências do Wan 3.0: entregue seus rostos e seu estilo como imagens, o movimento que você quer como clipes de vídeo, e vozes opcionais como áudio — e o Wan reinterpreta uma cena totalmente nova que mantém o movimento, os personagens e a sincronia. Sem assinatura, pague por clipe com créditos.
Opções de modelos
Escolha o fluxo que combina com a sua cena
Comece com um prompt, adicione referências quando precisar e escolha o caminho de geração que corresponda ao resultado.
Wan 3.0 (R2V)
O modo referência-para-vídeo padrão do Wan 3.0, exposto na Moosky como o compositor R2V. Alimente-o com um kit de referências — fotos paradas de rostos e figurino, painéis de estilo, clipes de movimento, tomadas de voz — rotule cada arquivo no prompt, e o Wan mantém a identidade, o estilo e o movimento enquanto interpreta a sua cena nova com áudio nativo.
Other reference-to-video models
R2V é um dos três modos de referência na Moosky. Quando uma tomada vive ou morre pelo diálogo falado, o MiniMax H3 Ref2V é a rota de diálogo; quando é ação cinética pesada, o Seedance 2.0 R2V lida melhor. A linha completa está no hub de referência-para-vídeo.
Exemplos de resultados
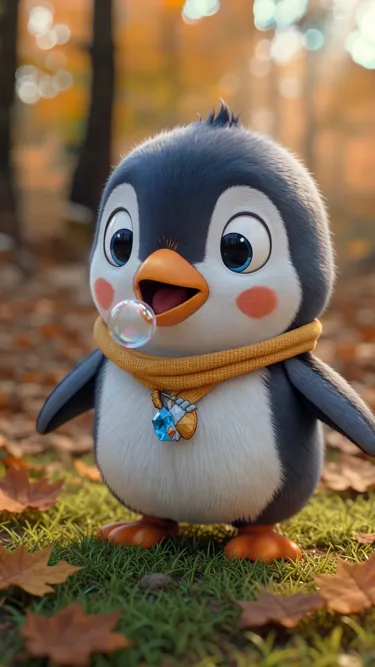
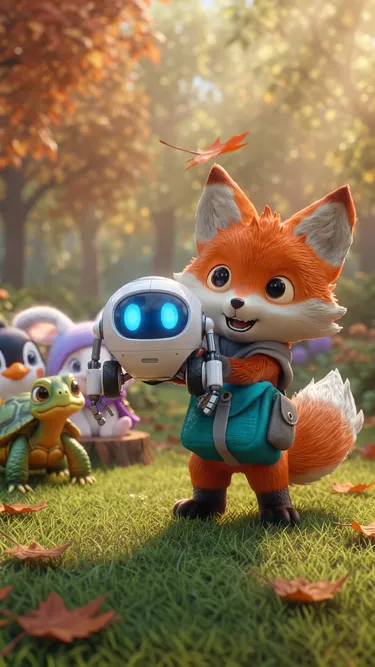
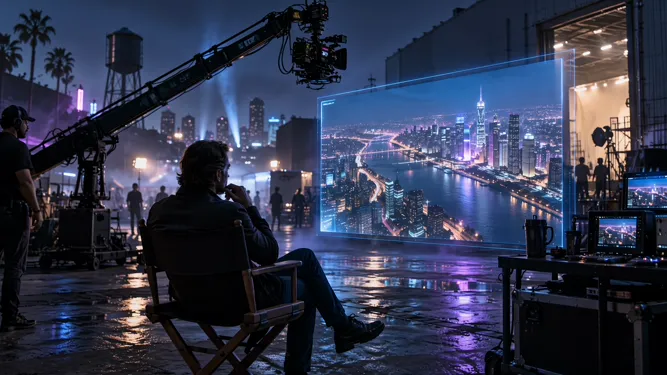
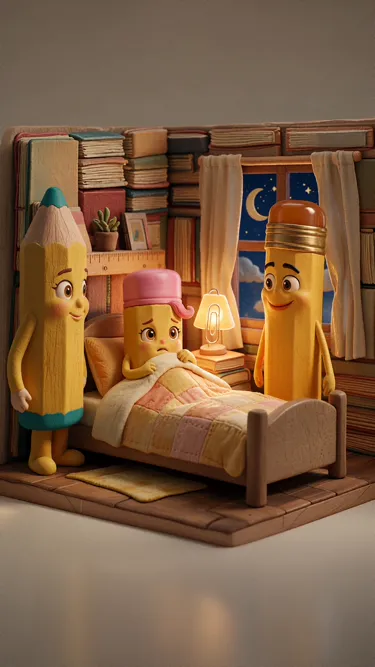
Clipes renderizados no modo R2V do Wan 3.0
Saídas reais de geração condicionada por referências com áudio nativo na Moosky.
Por que usar no Moosky AI
Ferramentas poderosas. Experiência sem atrito.
Renders condicionados por referências
Entregue ao modelo arquivos de referência em vez de reescrever a descrição do seu personagem a cada prompt. A identidade vive nos seus envios, não na sua redação, então a tomada nove parece com a tomada um.
Movimento a partir de um clipe de referência
Envie um vídeo curto do movimento que você quer — um loop de dança, uma sequência de luta, um ciclo de caminhada — e o Wan reencena esse movimento no seu personagem em uma cena nova.
Visual anime e estilizado
Trave planos de cor chapada, espessura de linha e paleta com referências de imagem de painel de estilo, para que o visual sobreviva ao movimento em vez de derivar para o fotorrealismo.
Referências de voz independentes
Anexe até cinco tomadas de áudio como referências e a fala interpretada mantém aquele timbre ao longo do clipe — o áudio pode acompanhar imagens ou vídeo.
Áudio nativo na mesma passada
O áudio de saída vem ligado por padrão: diálogo, Foley e ambiente são renderizados com a imagem. O lip-sync exato a palavras específicas ainda está amadurecendo.
Pague por clipe
R2V roda com créditos da Moosky (100 por $1). O compositor cotiza o custo exato a partir do comprimento e da resolução do seu clipe antes de qualquer execução.
Como funciona
Três passos simples até o resultado final
Carregue o kit de referências
Envie rostos e fotos paradas de figurino, um painel de estilo, o clipe de movimento que você quer igualar e tomadas de voz opcionais — em ordem, porque os rótulos seguem a ordem.
Rotule e dirija a cena
Prompte a nova tomada — cenário, ação, câmera, diálogo — e referencie cada arquivo pelo rótulo (Image 1, Video 1, Audio 1) para que a função fique explícita.
Renderize movimento + áudio
Escolha 2-30 segundos a 480P, 720P ou 1080P e gere — o clipe chega na sua fila com a sua faixa de áudio nativa.
Por que Wan 3.0 R2V para direção por referências com movimento consistente
A falha em que todo clipe IA de muito movimento esbarra não é o rosto, é o movimento. Peça «um breakdancer gira num flare» em texto puro e você recebe o movimento que o modelo inventa, que muda a cada re-roll. R2V é a resposta do Wan 3.0: os vídeos de referência carregam o movimento. Envie um clipe do movimento real, um loop de dança, uma sequência de luta, uma caminhada ensaiada, e o Wan condiciona o render a ele, reencenando esse movimento numa cena nova com o seu personagem. O prompt escreve o cenário e a câmera; o arquivo de referência escreve a coreografia. Uma tomada desviada então custa uma troca de arquivo, não um parágrafo de cirurgia de prompt: quando o soco parece um empurrão, carregue uma referência de movimento mais limpa e rode de novo, e rascunhos curtos em 480P continuam baratos o bastante para esboçar uma sequência inteira antes de comprometer uma tomada heroica em 1080P.
Para trabalho anime e estilizado o mesmo princípio trava o visual. Um clipe cel-shaded vive ou morre pela espessura de linha, pela paleta e por como cabelo e tecido se movem, detalhes que um parágrafo de prompt só consegue aproximar. Carregue três ou quatro frames prontos do seu personagem como referências de imagem e um clipe curto do movimento que você quer, e o render mantém o estilizado ao longo do movimento em vez de só no primeiro frame. Isso é transferência de movimento na prática: o gesto sobrevive da sua referência até a tomada, e o personagem sobrevive de tomada em tomada.
A disciplina de rotulagem é o que faz o kit funcionar. Cada arquivo assume a sua função pelo modo como você o nomeia no prompt: Image 1 o rosto, Image 2 a roupa, Video 1 o movimento de câmera, Video 2 a coreografia, Audio 1 a voz. Funções explícitas deixam uma cena com vários personagens carregar um kit de referências por função em uma única geração. E R2V não tem rota de primeiro frame; quando você precisa da imagem de abertura travada, isso é o modo FFLF na página do gerador Wan 3.0.
Cobrança por créditos
Preço simples e transparente
Sem assinaturas. Sem taxas escondidas. Pague apenas pelos créditos que usar.

Mais da Moosky AI
Conheça a suíte completa de ferramentas de IA.
Perguntas frequentes
O que é Wan 3.0 R2V?
R2V é o modo referência-para-vídeo do Wan 3.0: em vez de só um prompt, a geração é condicionada por arquivos que você fornece — até 10 imagens, 5 vídeos e 5 clipes de áudio independentes. As imagens carregam rostos, figurino e estilo; os vídeos carregam o movimento; o áudio carrega a voz. O Wan interpreta a sua cena nova mantendo tudo isso consistente, com áudio de saída nativo na mesma passada.
Posso transferir movimento de um vídeo para outro personagem?
É o caso de uso de transferência de movimento do R2V. Envie um clipe do movimento (1-15 segundos; todos os vídeos de referência abaixo de 15 s) como referência de Video, descreva o personagem e o cenário, e rotule as funções (Image 1 é o rosto, Video 1 é o movimento). O Wan reencena esse movimento no seu sujeito sem inventar o dele, aparando para entrada e clipe não passarem de 30 s. Para perseguições ou lutas em que a ação é a tomada, o Seedance 2.0 R2V lida com cinéticas mais pesadas.
Em que R2V difere do controle de primeiro/último frame?
Primeiro/último frame (FFLF) trava a imagem inicial e interpola opcionalmente até uma imagem final — ele controla composição e câmera entre dois frames. R2V substitui por completo a rota de primeiro frame: você condiciona por referências de identidade, estilo, movimento e voz, e não pode misturar mídias de referência com frames. Os dois modos renderizam 2-30 segundos a até 1080P com áudio nativo; em R2V, clipes que usam uma referência de vídeo são limitados para que entrada e saída fiquem dentro de 30 segundos.
R2V funciona para anime e animação estilizada?
Sim — é o modo para isso. O trabalho estilizado depende da espessura de linha, dos planos de cor chapada e de como cabelo e tecido se movem, detalhes que um prompt aproxima mal. Carregue um painel de estilo de três ou quatro frames acabados como referências de imagem mais um clipe de movimento, e o visual atravessa o movimento em vez de valer só no primeiro frame. O fluxo de poses-chave (imagens de abertura e fechamento) fica no modo FFLF da página do Wan 3.0.
Como eu controlo o que cada arquivo de referência faz?
Ordene os envios de propósito e rotule-os no prompt: Image 1 o rosto, Image 2 o figurino, Image 3 o painel de estilo, Video 1 o movimento de câmera, Video 2 a coreografia, Audio 1 a voz. O Wan lê esses rótulos e atribui a cada arquivo a sua função, e é assim que uma cena com vários personagens pode carregar um kit de referências por função em um único trabalho.
Quanto custa Wan 3.0 R2V na Moosky?
As gerações são cobradas em créditos (100 créditos por $1), com o custo seguindo duração e resolução — 480P, 720P ou 1080P entre 2 e 30 segundos (uma referência de vídeo aparando a saída máxima para que entrada mais clipe fiquem dentro de 30 s). Ligar ou desligar o áudio não muda a estimativa. O compositor cotiza o custo exato a partir do comprimento e da resolução do seu clipe antes de você enviar, e execuções com falha são devolvidas. Não é preciso assinatura.
Divulgação
A Moosky AI é uma plataforma independente e revendedora de acesso a modelos de IA. Os nomes de produtos, modelos e empresas exibidos nesta página pertencem aos respectivos titulares. A Moosky AI não é oficialmente afiliada, patrocinada nem endossada por esses provedores, salvo quando indicado expressamente. O conteúdo da página, os exemplos e as pré-visualizações podem incluir conteúdo assistido por IA e sintético.