Referência para Vídeo (R2V)
Referência para Vídeo.
O mesmo personagem.
Em cada clipe.
O R2V transforma uma imagem ou clipe de referência em papel de protagonista. Dê ao modelo o seu personagem, produto ou voz e ele o mantém consistente em todas as tomadas — o mesmo modo que quem procura chama de Ref2V. Sem assinatura, você paga por geração com créditos.
Opções de modelos
Escolha o fluxo que combina com a sua cena
Comece com um prompt, adicione referências quando precisar e escolha o caminho de geração que corresponda ao resultado.
MiniMax H3 R2V
Referência para vídeo com voz por referência e diálogo com lip-sync. O melhor quando o seu personagem tem que falar: envie uma referência de rosto mais áudio de voz opcional e o modelo interpreta a fala.
Wan 3.0 R2V
O modo de referência do Wan 3.0 mantém os sujeitos consistentes enquanto cuida de movimentos de câmera mais fortes e batidas de ação. Bom encaixe quando a tomada precisa de energia, não só um rosto falando.
Seedance 2.0 R2V
O modo de referência do Seedance 2.0 lê a sua folha de referências para um enquadramento cinematográfico — a faixa entre diálogo e ação quando o que precisa sustentar a tomada é a composição.
Exemplos de resultados
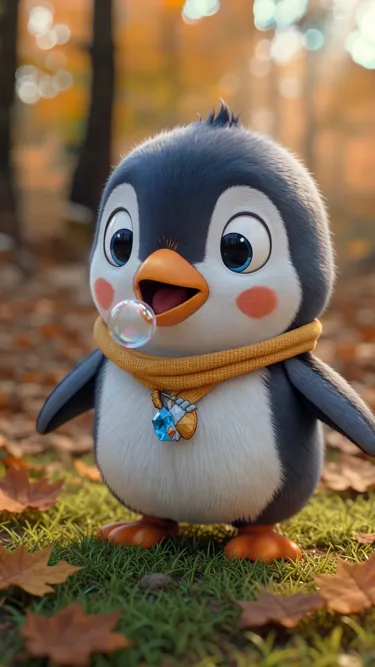
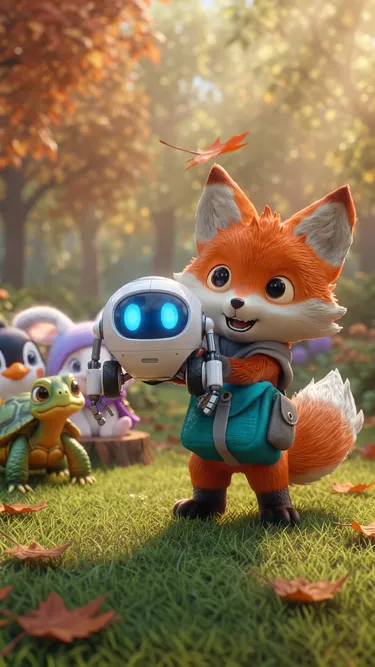
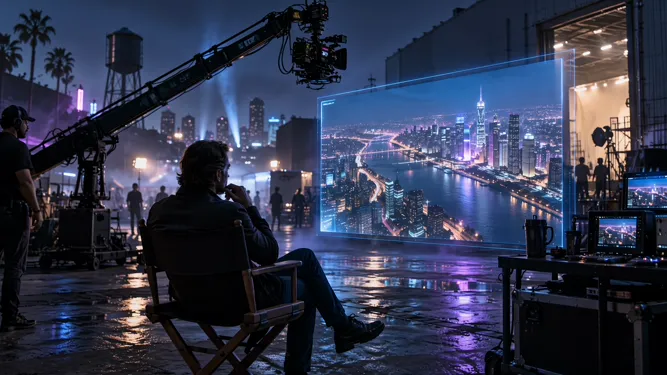
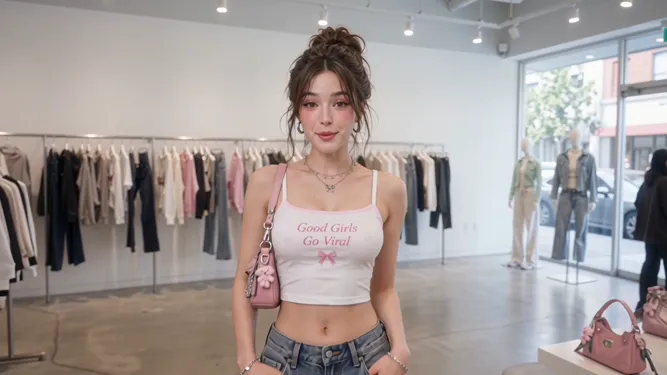
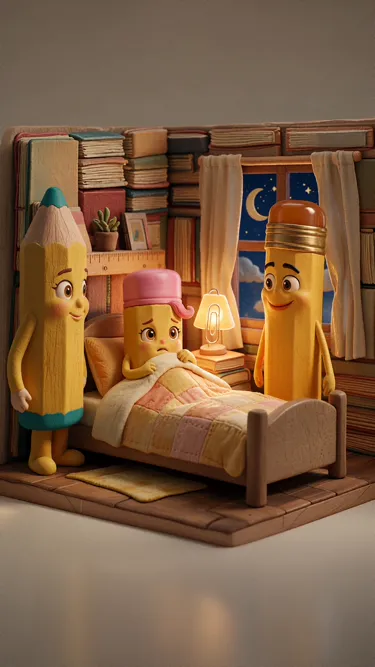
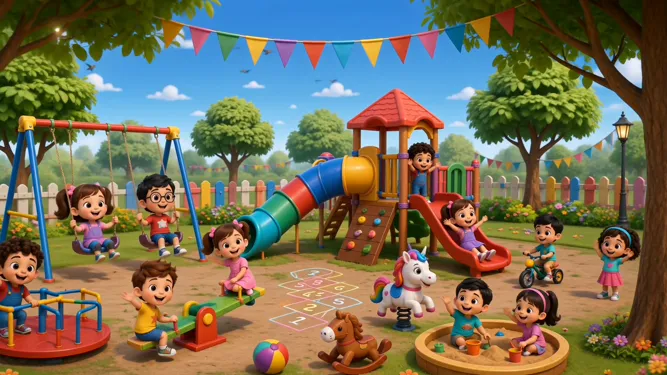
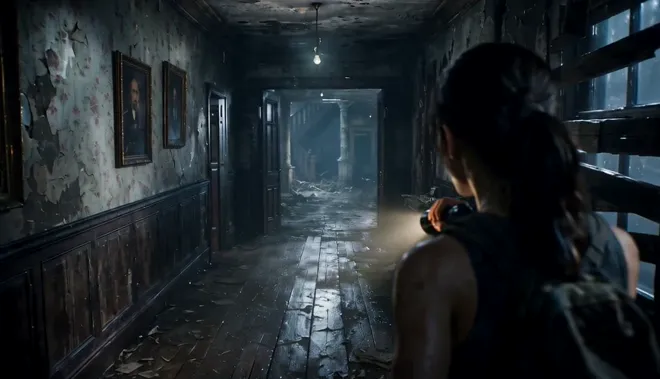
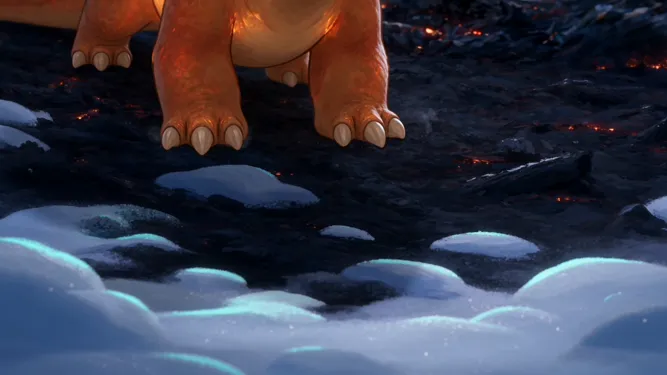
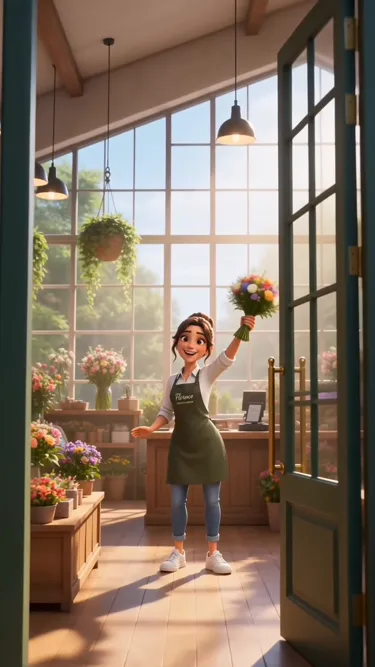
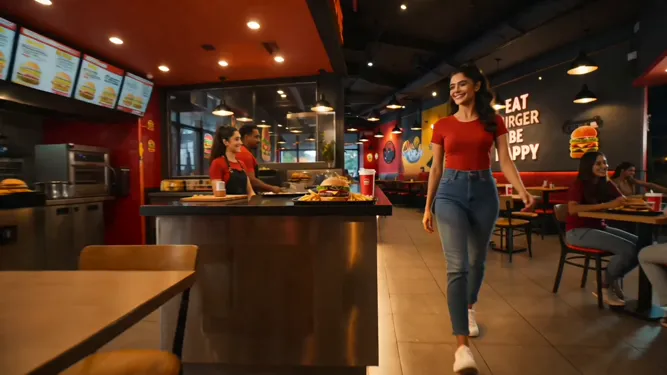
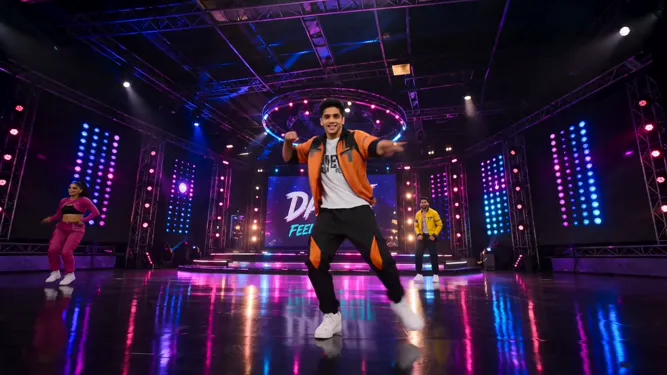
Clipes com personagem consistente criados com R2V
Saídas reais de geração guiada por referências no Moosky.
Por que usar no Moosky AI
Ferramentas poderosas. Experiência sem atrito.
Consistência de personagem
O mesmo rosto, roupa e produto em todos os clipes do seu projeto — não uma pessoa nova em cada render.
Áudio guiado por referências
Anexe referências de voz e obtenha fala com lip-sync que combina com a pessoa na tela.
Cenas multipersonagem
Dê a cada personagem o seu próprio slot de referência e mantenha o elenco estável em tomadas compartilhadas.
Três motores R2V
Alterne entre MiniMax, Wan 3.0 e Seedance R2V a partir do mesmo saldo de créditos.
Sem assinatura
Pague por geração. O R2V é a forma mais rápida de queimar uma assinatura que você mal usa.
Uso comercial
Use clipes com referência em anúncios, shorts e trabalho para clientes.
Como funciona
Três passos simples até o resultado final
Envie as referências
Adicione uma imagem de rosto ou produto — e opcionalmente um clipe de voz para cenas de diálogo.
Descreva a cena
Escreva o prompt da nova tomada: ambiente, ação, câmera. A referência carrega a identidade.
Gere clipes consistentes
Renderize no motor R2V que encaixe e mantenha o mesmo personagem em todo o seu projeto.
Como o R2V AI funciona no Moosky
"r2v ai" — escrito ref2v quando o pessoal copia a grafia do MiniMax — é o atalho para a geração referência para vídeo: você entrega ao modelo uma folha de referências, um rosto, um produto, um clipe de voz, e ele condiciona cada render sobre eles. O prompt escreve a cena; as referências fecham o elenco, então o clipe um e o clipe vinte mostram a mesma pessoa.
Três motores o executam, e a escolha é sobre o trabalho. O MiniMax H3 R2V é a faixa de diálogo: voz por referência e falas com lip-sync. O Wan 3.0 R2V é a faixa de movimento — câmera mais forte e transferência de movimento a partir de um clipe de referência. O Seedance 2.0 R2V fica entre ambos com enquadramento cinematográfico. Cada compositor cota o custo em créditos antes de gerar.
O trabalho com referências é iterativo — refações, restilizações, mais-uma-versão — então o Moosky cobra por clipe sobre um saldo de créditos que nunca expira, em qualquer motor. Novo no modo? Nossa explicação em linguagem clara cobre como o R2V difere de imagem para vídeo; esta página é onde você faz os clipes.
Cobrança por créditos
Preço simples e transparente
Sem assinaturas. Sem taxas escondidas. Pague apenas pelos créditos que usar.

Mais da Moosky AI
Conheça a suíte completa de ferramentas de IA.
Perguntas frequentes
O que é referência para vídeo (R2V) em IA?
R2V é um modo de geração em que o modelo recebe uma ou mais imagens de referência (ou clipes) e condiciona o vídeo sobre elas, mantendo um personagem, objeto ou estilo consistente de tomada em tomada. Em vez de descrever o seu herói em cada prompt, você mostra ao modelo como ele é uma vez e ele carrega essa identidade pela cena.
Em que o R2V difere de imagem para vídeo?
Imagem para vídeo anima uma única imagem parada — a foto vira a primeira tomada. O R2V vai além: as referências definem identidade, não composição, então você pode colocar o mesmo personagem em cenas, ângulos e figurinos novos enquanto ele continua sendo reconhecivelmente ele mesmo.
Qual modelo R2V devo escolher?
Escolha o MiniMax H3 R2V quando os seus personagens falarem — ele cuida melhor da voz por referência e do diálogo com lip-sync. Escolha o Wan 3.0 R2V quando a tomada for de movimento e câmera. O Seedance 2.0 R2V fica entre os dois com enquadramento cinematográfico forte. Os três rodam com os mesmos créditos do Moosky.
O R2V consegue manter o mesmo personagem em vários clipes?
Sim — é disso que se trata. Reutilize a mesma imagem de referência como semente de cada clipe do projeto e o modelo preserva o rosto e o estilo. Para cenas de diálogo, adicione uma referência de voz para que o personagem soe consistente também.
Quanto custa o R2V no Moosky?
As gerações R2V são cobradas em créditos como todo o resto no Moosky (100 créditos por $1), e o custo exato de cada clipe aparece no compositor antes de rodar. Não há assinatura e os créditos nunca expiram — você paga pelos clipes que realmente gera.
Ref2V é a mesma coisa que R2V?
Sim — ref2v (também escrito ref2va) é só a grafia abreviada de referência para vídeo que o MiniMax usa para o modo do H3, e quem busca usa para a categoria inteira. Cada clipe desta página é um clipe ref2v: o motor que você escolher condiciona o render sobre as suas referências. Se a sua tomada vive ou morre pelo diálogo falado e uma voz que se sustente, abra a página MiniMax H3 Ref2V, que aprofunda nesse modo; para trabalho de personagem entre motores, este hub é o ponto de partida.
Posso trocar um rosto num vídeo sem regravá-lo?
Sim — isso é um recast, e roda sobre o mesmo condicionamento por referência que todo o resto daqui. Envie uma foto de rosto clara e consentida mais a direção da tomada original (storyboard, blocking, câmera), e um motor R2V re-renderiza a cena com essa identidade travada; rascunhe a comparação de casting barato no LTX 2.5 e depois passe a versão final para hero no Wan 3.0 ou Seedance. A regra de consentimento é firme: use o seu próprio rosto ou um com permissão explícita, e etiquete os recasts de pitch ou previz como gerados.
Divulgação
A Moosky AI é uma plataforma independente e revendedora de acesso a modelos de IA. Os nomes de produtos, modelos e empresas exibidos nesta página pertencem aos respectivos titulares. A Moosky AI não é oficialmente afiliada, patrocinada nem endossada por esses provedores, salvo quando indicado expressamente. O conteúdo da página, os exemplos e as pré-visualizações podem incluir conteúdo assistido por IA e sintético.