من المرجع إلى الفيديو (R2V)
من المرجع إلى الفيديو.
الشخصية ذاتها.
في كل مقطع.
تحوّل R2V صورة مرجعية أو مقطعاً إلى دور بطولي. أعطِ النموذج شخصيتك أو منتجك أو صوتك فيحافظ على ثباتها عبر كل لقطة — الوضع نفسه الذي يسمّيه الباحثون Ref2V. بلا اشتراك، بالدفع لكل توليد بالأرصدة.
خيارات النماذج
اختر المسار الذي يناسب مشهدك
ابدأ بوصف نصي، وأضف مراجع عند الحاجة، ثم اختر مسار التوليد الذي يطابق النتيجة التي تريدها.
MiniMax H3 R2V
توليد من المرجع إلى الفيديو بصوت لكل مرجع وحوار متزامن مع الشفاه. الأفضل حين يجب أن تنطق شخصيتك: ارفع صورة مرجعية للوجه مع مقطع صوتي اختياري، فيؤدّي النموذج الجملة.
Wan 3.0 R2V
يحافظ وضع المراجع في Wan 3.0 على ثبات المواضيع بينما يتعامل مع حركات كاميرا أقوى ولقطات حركة. مناسب حين تحتاج اللقطة طاقة، لا وجهاً يتحدث فحسب.
Seedance 2.0 R2V
يقرأ وضع المراجع في Seedance 2.0 ورقة مراجعك لتأطير سينمائي — المسار بين الحوار والحركة حين يجب أن تحمل تكوينُ اللقطة عبأها.
أمثلة المخرجات
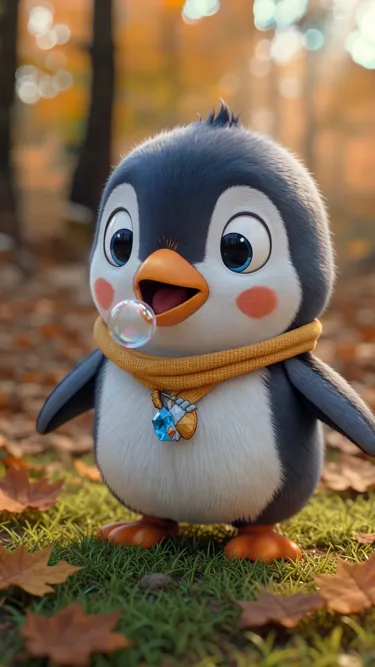
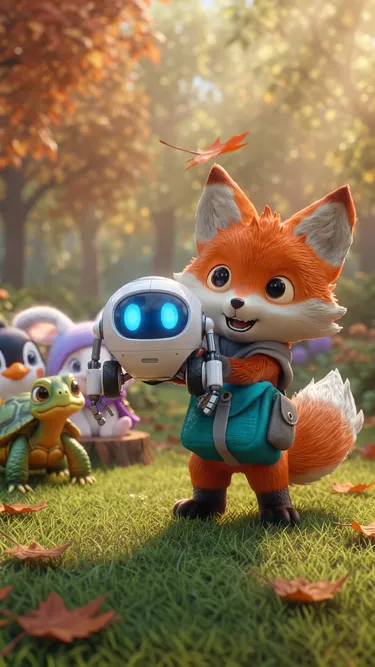
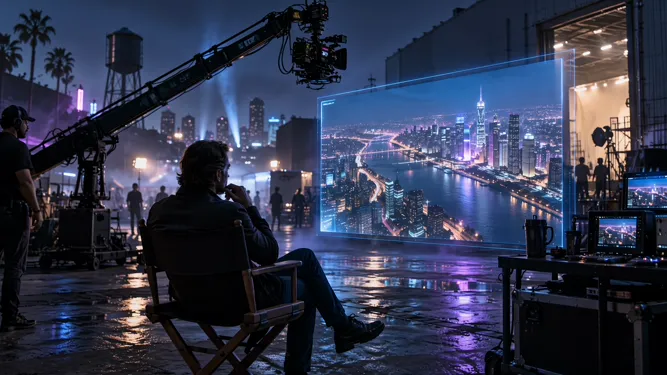
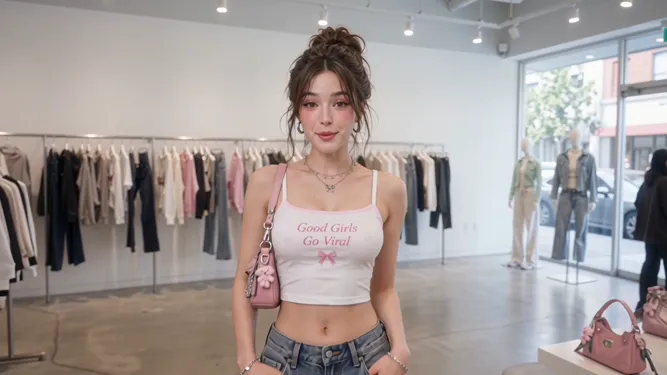
مقاطع متسقة الشخصيات صنعتها R2V
مُخرَجات حقيقية من التوليد الموجَّه بالمراجع على Moosky.
لماذا تستخدمه على Moosky AI
أدوات قوية. تجربة سلسة.
ثبات الشخصية
الوجه والزيّ والمنتج ذاتهم في كل مقطع بمشروعك — لا شخصٌ جديد كل توليد.
صوت موجَّه بالمرجع
أرفق مراجع صوتية واحصل على كلام متزامن مع الشفاه يطابق من يظهر على الشاشة.
مشاهد متعددة الشخصيات
خصص لكل شخصية خانة مرجعها الخاص وأبقِ الطاقم ثابتا في اللقطات المشتركة.
ثلاثة محركات R2V
بدّل بين MiniMax وWan 3.0 وSeedance R2V من الرصيد نفسه.
بلا اشتراك
ادفع لكل توليد. R2V أسرع طريقة لتبديد اشتراك تكاد لا تستخدمه.
استخدام تجاري
استعمل المقاطع الموجَّهة بالمراجع في الإعلانات والفيديوهات القصيرة وأعمال العملاء.
كيف يعمل
ثلاث خطوات بسيطة حتى الناتج النهائي
ارفع المراجع
أضف صورة وجه أو منتج — ومقطع صوتي اختياريا لمشاهد الحوار.
صف المشهد
اكتب اللقطة الجديدة: المكان والحركة والكاميرا. المرجع يحمل الهوية.
ولّد مقاطع متسقة
ولّد على محرك R2V الملائم واحتفظ بالشخصية نفسها عبر مشروعك.
كيف يعمل R2V بالذكاء الاصطناعي على Moosky
"r2v ai" — تُكتب ref2v حين ينقل الناس لفظ MiniMax — هي اختصار التوليد من المرجع إلى الفيديو: تسلم النموذج ورقة مراجع، أو وجها، أو منتجا، أو مقطع صوت، فيكيّف كل توليد عليها. الطلب يكتب المشهد، والمراجع تثبّت الطاقم، فتُظهر اللقطة الأولى والعشرون الشخص نفسه.
ثلاثة محركات تشغّله، والاختيار حسب المهمة. MiniMax H3 R2V مسار الحوار: صوت لكل مرجع وأصوات متزامنة مع الشفاه. Wan 3.0 R2V مسار الحركة — كاميرا أقوى ونقل حركة من مقطع مرجعي. ويستقر Seedance 2.0 R2V بينهما بتأطير سينمائي. كل مؤلّف يعرض كلفة الأرصدة قبل التوليد.
العمل بالمراجع تكراري — إعادة لقطات، وتنسيقات جديدة، ونسخ إضافية — فيفوتر Moosky لكل مقطع على رصيد أرصدة لا ينتهي أبدا، على أي محرك. جديد على هذا الوضع؟ شرحنا بلغة بسيطة يبيّن كيف تختلف R2V عن تحويل الصور إلى فيديو؛ وهذه الصفحة حيث تصنع المقاطع.
نظام الأرصدة
تسعير بسيط وشفاف
بدون اشتراكات. بدون رسوم خفية. تدفع فقط مقابل الأرصدة التي تستخدمها.

المزيد من Moosky AI
استكشف مجموعتنا الكاملة من أدوات الذكاء الاصطناعي.
الأسئلة الشائعة
ما هو التحول من مرجع إلى فيديو (R2V) في الذكاء الاصطناعي؟
R2V وضع توليد يتلقى فيه النموذج صورة مرجعية واحدة أو أكثر (أو مقاطع) ويكيّف الفيديو عليها، فيحافظ على ثبات شخصية أو غرض أو أسلوب من لقطة إلى أخرى. فبدل أن تصف بطلك في كل طلب، تُري النموذج شكله مرة واحدة فيحمل تلك الهوية عبر المشهد.
بماذا تختلف R2V عن التحول من صورة إلى فيديو؟
تحويل الصورة إلى فيديو يحرّك إطاراً ثابتا — فتصير الصورة نفسها اللقطة الأولى. أما R2V فيذهب أبعد: المراجع تحدد الهوية لا التكوين، فتضع الشخصية نفسها في مشاهد وزوايا وأزياء جديدة وهي تبقى معروفة.
أي نموذج R2V أختار؟
اختر MiniMax H3 R2V حين تنطق شخصياتك — فهو الأمثل بصوت لكل مرجع وحوار متزامن مع الشفاه. واختر Wan 3.0 R2V حين تدور اللقطة حول الحركة والتصوير. ويستقر Seedance 2.0 R2V بينهما بتأطير سينمائي قوي. الثلاثة تعمل بأرصدة Moosky نفسها.
هل تستطيع R2V الحفاظ على الشخصية نفسها عبر عدة مقاطع؟
نعم — هذا هو المغزى. أعد استخدام الصورة المرجعية نفسها كبذرة لكل مقطع في المشروع فيحفظ النموذج الوجه والتنسيق. و لمشاهد الحوار أضف مرجع صوت لتحصل على صوت ثابت للشخصية كذلك.
كم تكلف R2V على Moosky؟
تُفوتر توليدات R2V بالأرصدة ككل شيء على Moosky (100 رصيد مقابل 1$)، وتُعرض الكلفة الدقيقة لكل مقطع في المؤلّف قبل التشغيل. لا يوجد اشتراك والأرصدة لا تنتهي أبداً — تدفع فقط مقابل المقاطع التي تولّدها فعلا.
هل ref2V نفس R2V؟
نعم — ref2v (تُكتب أيضاً ref2va) هي مجرد اللفظ المختصر لوضع من المرجع إلى الفيديو الذي تستخدمه MiniMax لوضع H3، ويستخدمها الباحثون للفئة كلها. كل مقطع في هذه الصفحة هو مقطع ref2v: أي محرك تختاره يكيّف التوليد على مراجعك. وإن كانت لقطة حياتها وموتها في حوار منطوق وصوت حامل، فافتح صفحة MiniMax H3 Ref2V المتعمقة في هذا الوضع وحده؛ ولعمل شخصيات عبر المحركات هذه الصفحة نقطة الانطلاق.
هل أستطيع تغيير وجه في فيديو دون إعادة تصويره؟
نعم — هذا إعادة تمثيل، ويعمل على التكييف المرجعي نفسه كغيره هنا. ارفع صورة وجه واحدة واضحة وعن رضا، مع توجيه اللقطة الأصلية (ستوري بورد، تموضع، كاميرا)، فتعيد محرك R2V توليد المشهد بتلك الهوية مثبّتة؛ جرّب مقارنة الاختيار رخيصا على LTX 2.5، ثم أنفق التمريرة الأبرز على Wan 3.0 أو Seedance للفائزة. قاعدة الرضا صارمة: استخدم وجهك أو وجها تملك إذنا صريحا باستخدامه، وسمِّ إعادة التمثيل المولّدة في العروض والتحضير البصري كمحتوى مُولَّد.
إفصاح
Moosky AI منصة مستقلة أعادت بيع الوصول إلى نماذج الذكاء الاصطناعي. أسماء المنتجات والنماذج والشركات الظاهرة في هذه الصفحة مملوكة لأصحابها المعنيين. Moosky AI غير تابعة رسميًا لهؤلاء المزودين ولا يرعونها ولا يصادقون عليها ما لم يُذكر ذلك صراحة. قد يتضمن محتوى الصفحة والمثل والمعاينات محتوى بمساعدة الذكاء الاصطناعي ومحتوى اصطناعيًا.