De la référence à la vidéo (R2V)
De la référence à la vidéo.
Même personnage.
Sur chaque clip.
R2V transforme une image ou un clip de référence en rôle principal. Donnez au modèle votre personnage, votre produit ou votre voix, il les garde cohérents à chaque plan — le même mode que les recherches appellent Ref2V. Pas d'abonnement, paiement à la génération en crédits.
Options de modèles
Choisissez le flux qui correspond à votre scène
Commencez avec un prompt, ajoutez des références au besoin, puis choisissez la voie de génération qui correspond au résultat.
MiniMax H3 R2V
Référence-vers-vidéo avec voix par référence et dialogues synchronisés sur les lèvres. Le meilleur choix quand votre personnage doit parler : importez une référence de visage plus un audio de voix facultatif, et le modèle joue la réplique.
Wan 3.0 R2V
Le mode référence de Wan 3.0 garde les sujets cohérents tout en gérant des mouvements de caméra plus forts et des beats d'action. Idéal quand le plan demande de l'énergie, pas seulement une tête qui parle.
Seedance 2.0 R2V
Le mode référence de Seedance 2.0 lit votre fiche de référence pour un cadrage cinématique — la voie entre dialogue et action quand c'est la composition du plan qui doit tout porter.
Exemples de résultats
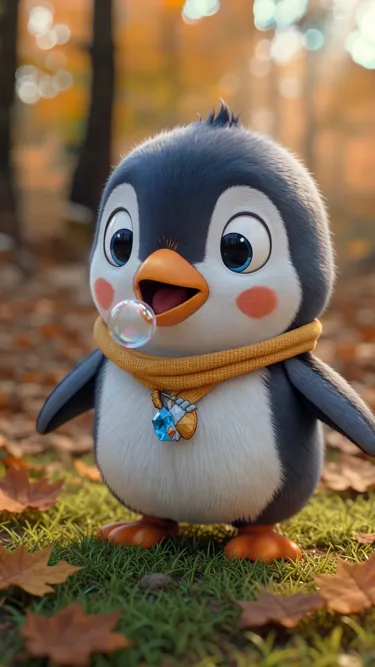
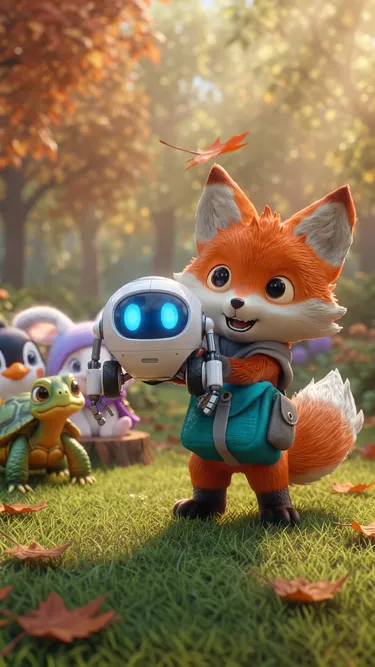
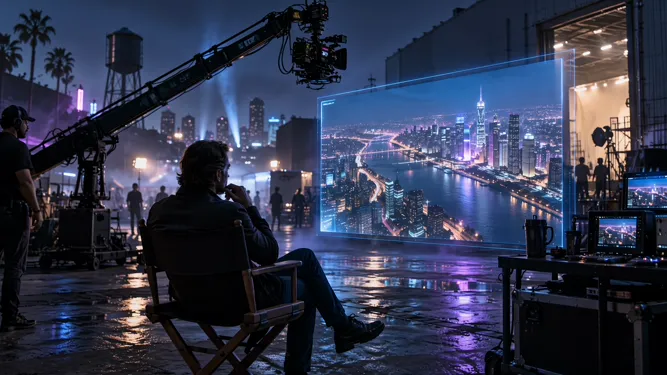
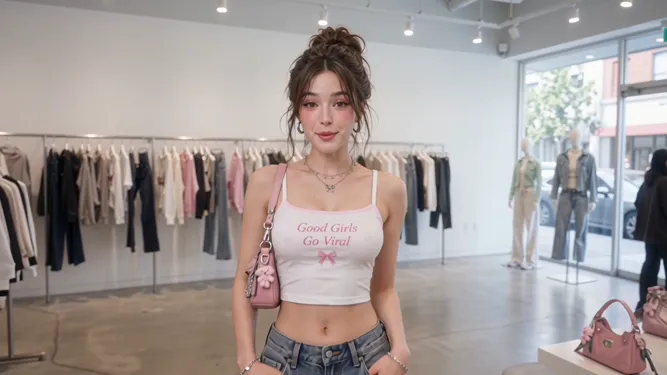
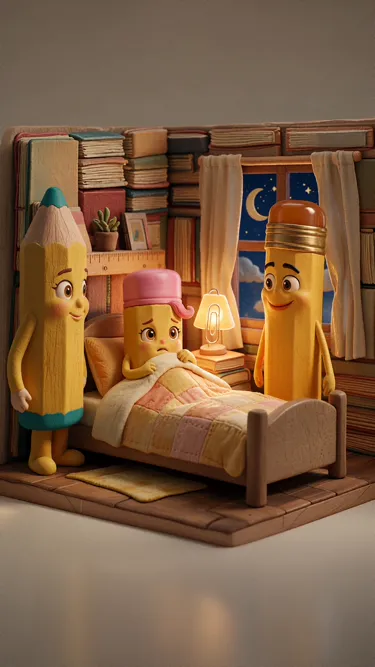
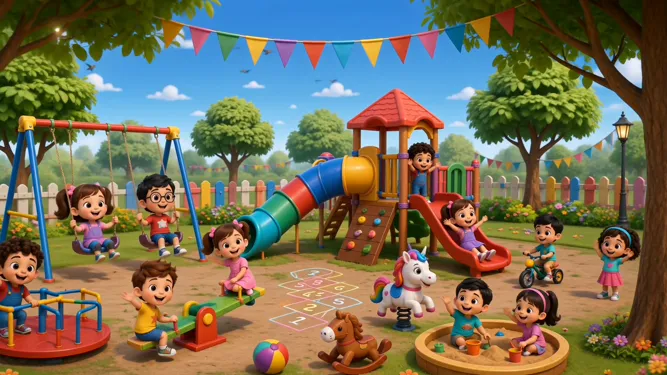
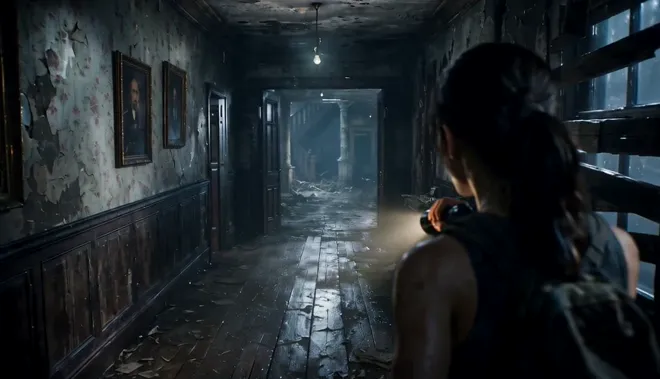
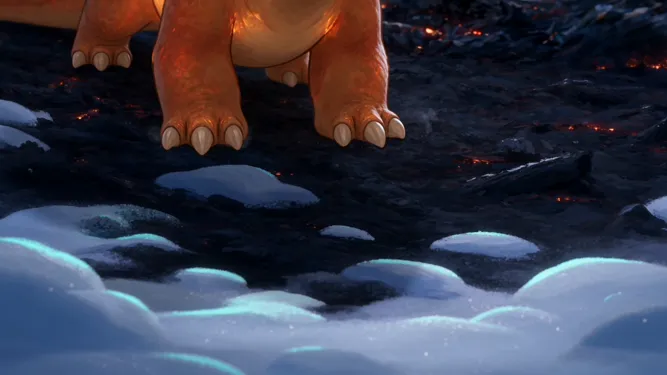
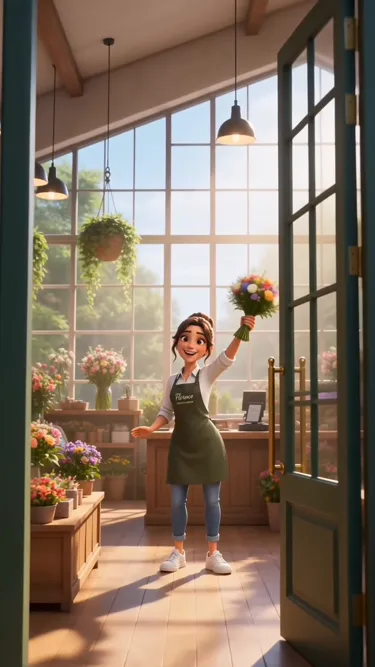
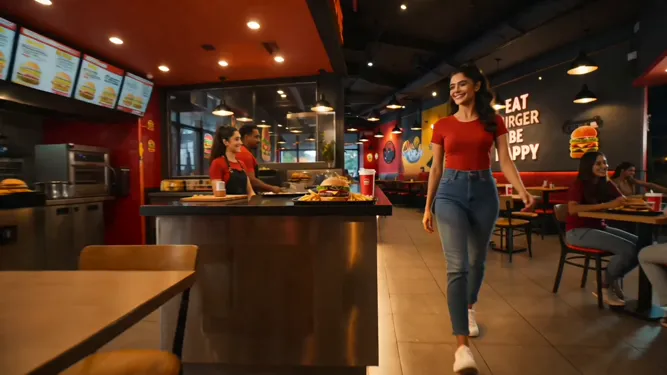
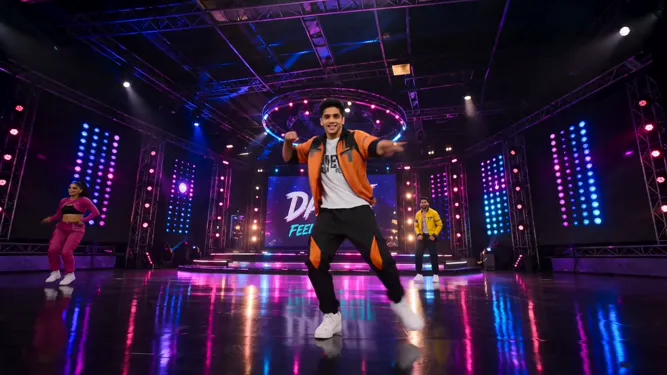
Des clips à personnage cohérents créés avec R2V
Vrais rendus issus de la génération pilotée par référence sur Moosky.
Pourquoi l’utiliser sur Moosky AI
Des outils puissants. Une expérience sans accroc.
Cohérence du personnage
Le même visage, la même tenue, le même produit sur chaque clip du projet — pas une nouvelle personne à chaque rendu.
Audio piloté par la référence
Joignez des références de voix et obtenez une parole synchronisée qui correspond à la personne à l'écran.
Scènes multi-personnages
Donnez à chaque personnage son propre emplacement de référence et gardez le casting stable dans les plans partagés.
Trois moteurs R2V
Passez de MiniMax, Wan 3.0 et Seedance R2V depuis le même solde de crédits.
Sans abonnement
Payez à la génération. R2V est la façon la plus rapide de griller un abonnement que vous peine à utiliser.
Usage commercial
Utilisez les clips pilotés par référence en pubs, shorts et travail client.
Comment ça marche
Trois pas simples jusqu’au résultat final
Importez les références
Ajoutez une image de visage ou de produit — et éventuellement un clip audio pour les scènes dialoguées.
Décrivez la scène
Décrivez le nouveau plan : décor, action, caméra. La référence porte l'identité.
Générez des clips cohérents
Rendez sur le moteur R2V qui convient et gardez le même personnage dans tout votre projet.
Comment fonctionne R2V sur Moosky
« r2v ai » — écrit ref2v quand on reprend l'orthographe de MiniMax — est le raccourci de la génération de la référence à la vidéo : vous donnez au modèle une fiche de référence, un visage, un produit, un clip audio, et il conditionne chaque rendu dessus. Le prompt écrit la scène ; les références verrouillent le casting, si bien que le clip un et le clip vingt montrent la même personne.
Trois moteurs l'exécutent, et le choix dépend du job. MiniMax H3 R2V est la filière dialogue : voix par référence et répliques synchronisées. Wan 3.0 R2V est la filière mouvement — mouvements de caméra plus forts et transfert de mouvement depuis un clip de référence. Seedance 2.0 R2V s'installe entre eux avec un cadrage cinématique. Chaque compositeur affiche le coût en crédits avant la génération.
Le travail sur référence est itératif — retournages, restylisations, versions « une de plus » — aussi Moosky facture au clip sur un solde de crédits qui n'expire jamais, sur n'importe quel moteur. Nouveau sur ce mode ? Notre explicateur en langage clair détaille comment R2V diffère de l'image-vers-vidéo ; cette page est celle où vous fabriquez les clips.
Crédits
Une tarification simple et honnête
Sans abonnement. Sans frais cachés. Payez uniquement les crédits que vous utilisez.

Plus de Moosky AI
Explorez toute notre suite d’outils IA.
Questions fréquentes
Qu'est-ce que reference to video (R2V) en IA ?
R2V est un mode de génération où le modèle reçoit une ou plusieurs images (ou clips) de référence et conditionne la vidéo dessus, gardant un personnage, un objet ou un style cohérent de plan en plan. Au lieu de décrire votre héros dans chaque prompt, vous montrez au modèle à quoi il ressemble une fois, et il porte cette identité à travers la scène.
En quoi R2V diffère de l'image-vers-vidéo ?
L'image-vers-vidéo anime une seule image fixe — la photo devient le premier plan. R2V va plus loin : les références définissent l'identité, pas la composition, si bien que vous placez le même personnage dans de nouvelles scènes, angles et tenues tout en le gardant reconnaissable.
Quel modèle R2V choisir ?
Choisissez MiniMax H3 R2V quand vos personnages parlent — il gère au mieux la voix par référence et les dialogues synchronisés. Choisissez Wan 3.0 R2V quand le plan tourne autour du mouvement et de la caméra. Seedance 2.0 R2V se place entre les deux avec un cadrage cinématique soigné. Les trois tournent sur les mêmes crédits Moosky.
R2V peut-il garder le même personnage sur plusieurs clips ?
Oui — c'est tout l'intérêt. Réutilisez la même image de référence comme graine pour chaque clip du projet, et le modèle préserve le visage et le style. Pour les scènes dialoguées, ajoutez une référence de voix pour que le personnage reste cohérent à l'oreille aussi.
Combien coûte R2V sur Moosky ?
Les générations R2V sont facturées en crédits comme tout le reste sur Moosky (100 crédits pour 1$), et le coût exact de chaque clip s'affiche dans le compositeur avant le lancement. Pas d'abonnement et les crédits n'expirent jamais — vous ne payez que les clips réellement générés.
ref2V, c'est la même chose que R2V ?
Oui — ref2v (aussi écrit ref2va) n'est que l'orthographe abrégée de reference-to-video que MiniMax emploie pour le mode de H3, et les chercheurs l'utilisent pour toute la catégorie. Chaque clip de cette page est un clip ref2v : quel que soit le moteur choisi, le rendu est conditionné sur vos références. Si votre plan se joue sur un dialogue parlé et une voix tenue, ouvrez la page MiniMax H3 Ref2V qui creuse ce seul mode ; pour un travail de personnage multi-moteurs, ce hub est le point de départ.
Puis-je changer un visage dans une vidéo sans la retourner ?
Oui — c'est un recast, sur le même conditionnement de référence que tout le reste ici. Importez une photo de visage nette et consentie, plus la direction du plan d'origine (storyboard, blocking, caméra), et un moteur R2V relit la scène avec cette identité verrouillée ; auditez le casting à bas coût sur LTX 2.5, puis passez en hero sur Wan 3.0 ou Seedance pour le gardé. Règle du consentement ferme : votre visage ou un visage dont vous détenez l'autorisation explicite, et étiquetez les recasts de pitch ou previz comme générés.
Divulgation
Moosky AI est une plateforme indépendante et revendeuse d’accès à des modèles d’IA. Les noms de produits, de modèles et d’entreprises affichés sur cette page appartiennent à leurs titulaires respectifs. Moosky AI n’est officiellement affiliée, parrainée ni endossée par ces fournisseurs sauf mention expresse. Le contenu de la page, les exemples et les aperçus peuvent inclure du contenu assisté par IA et synthétique.