Referencia a Video (R2V)
Referencia a Video.
El mismo personaje.
En cada clip.
R2V convierte una imagen o clip de referencia en un papel protagonista. Dale al modelo tu personaje, producto o voz y lo mantiene consistente en todas las tomas — el mismo modo que quienes buscan llaman Ref2V. Sin suscripción, pagas por generación con créditos.
Opciones de modelos
Elegí el flujo que mejor se ajusta a tu proyecto
Empezá con un prompt, sumá referencias si hace falta y elegí el camino de generación que coincida con el resultado que buscás.
MiniMax H3 R2V
Referencia a video con voz por referencia y diálogo con lip-sync. Lo mejor cuando tu personaje tiene que hablar: sube una referencia de cara más audio de voz opcional y el modelo interpreta la línea.
Wan 3.0 R2V
El modo de referencia de Wan 3.0 mantiene los sujetos consistentes mientras maneja movimientos de cámara más fuertes y golpes de acción. Buen encaje cuando la toma necesita energía, no solo una cara hablando.
Seedance 2.0 R2V
El modo de referencia de Seedance 2.0 lee tu hoja de referencias para un encuadre cinematográfico — el carril entre diálogo y acción cuando lo que tiene que sostener la toma es la composición.
Ejemplos de resultados
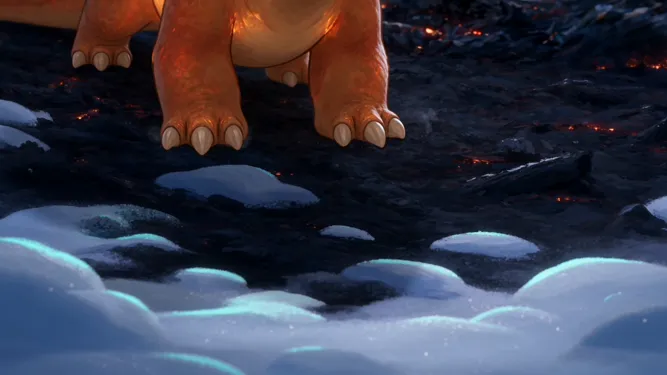
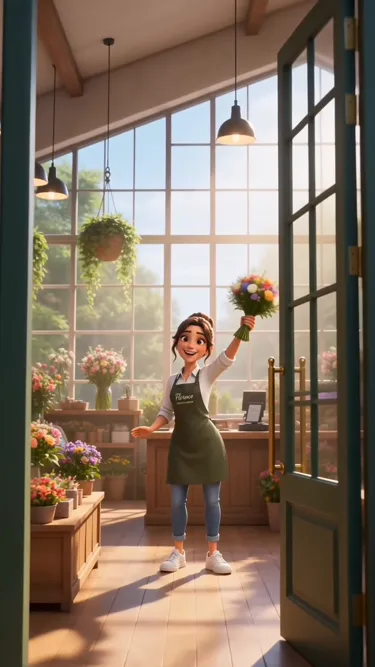
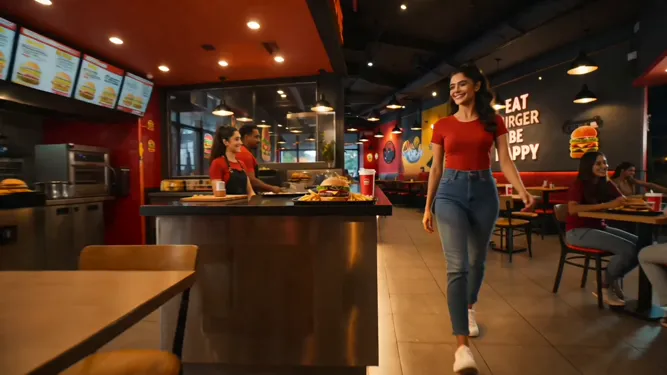
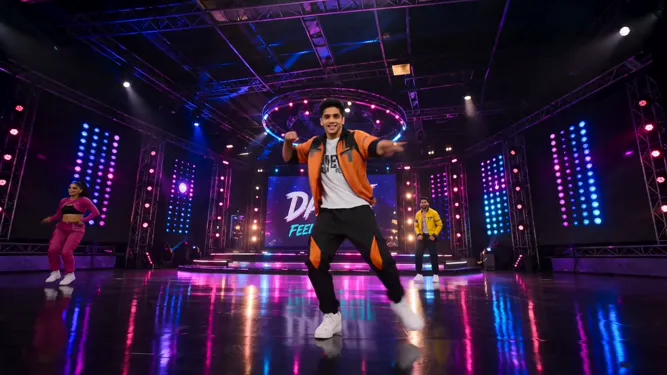
Clips con personaje consistente creados con R2V
Salidas reales de generación con referencias en Moosky.
Por qué usarlo en Moosky AI
Herramientas potentes. Experiencia sin fricción.
Consistencia de personaje
La misma cara, ropa y producto en todos los clips de tu proyecto — no una persona nueva en cada render.
Audio dirigido por referencias
Adjunta referencias de voz y obtén habla con lip-sync que coincide con la persona en pantalla.
Escenas multipersonaje
Dale a cada personaje su propio hueco de referencia y mantén el elenco estable en tomas compartidas.
Tres motores R2V
Cambia entre MiniMax, Wan 3.0 y Seedance R2V desde el mismo saldo de créditos.
Sin suscripción
Paga por generación. R2V es la forma más rápida de quemar una suscripción que apenas usas.
Uso comercial
Usa clips con referencia en anuncios, shorts y trabajo de cliente.
Cómo funciona
Tres pasos simples hasta el resultado final
Sube las referencias
Añade una imagen de cara o producto — y opcionalmente un clip de voz para escenas de diálogo.
Describe la escena
Escribe el prompt de la nueva toma: entorno, acción, cámara. La referencia carga la identidad.
Genera clips consistentes
Renderiza en el motor R2V que encaje y mantén el mismo personaje en todo tu proyecto.
Cómo funciona R2V AI en Moosky
"r2v ai" — escrito ref2v cuando la gente copia la grafía de MiniMax — es el atajo para la generación referencia a video: le entregas al modelo una hoja de referencias, una cara, un producto, un clip de voz, y él acondiciona cada render sobre ellos. El prompt escribe la escena; las referencias cierran el elenco, así que el clip uno y el clip veinte muestran a la misma persona.
Tres motores lo ejecutan, y la elección va del trabajo. MiniMax H3 R2V es el carril de diálogo: voz por referencia y líneas con lip-sync. Wan 3.0 R2V es el carril de movimiento — cámara más fuerte y transferencia de movimiento desde un clip de referencia. Seedance 2.0 R2V se sienta entre ambos con encuadre cinematográfico. Cada compositor cotiza el coste en créditos antes de generar.
El trabajo con referencias es iterativo — repeticiones, restilizados, un-versión-más — así que Moosky factura por clip sobre un saldo de créditos que nunca caduca, en cualquier motor. ¿Nuevo en el modo? Nuestro explicador en lenguaje claro cubre cómo R2V difiere de imagen a video; esta página es donde haces los clips.
Créditos
Precio simple y honesto
Sin suscripciones. Sin costos ocultos. Pagás solo los créditos que usás.

Más de Moosky AI
Explorá toda la suite de herramientas de IA.
Preguntas frecuentes
¿Qué es referencia a video (R2V) en IA?
R2V es un modo de generación en el que el modelo toma una o más imágenes de referencia (o clips) y acondiciona el video sobre ellas, manteniendo un personaje, objeto o estilo consistente de toma en toma. En vez de describir a tu héroe en cada prompt, le enseñas al modelo cómo es una vez y él lleva esa identidad por la escena.
¿En qué se diferencia R2V de imagen a video?
Imagen a video anima una sola imagen fija — la foto se convierte en el primer plano. R2V va más lejos: las referencias definen identidad, no composición, así que puedes colocar al mismo personaje en escenas, ángulos y vestuarios nuevos mientras sigue siendo reconociblemente él.
¿Qué modelo R2V debo elegir?
Elige MiniMax H3 R2V cuando tus personajes hablen — maneja mejor la voz por referencia y el diálogo con lip-sync. Elige Wan 3.0 R2V cuando la toma vaya de movimiento y cámara. Seedance 2.0 R2V se sitúa entre ambos con encuadre cinematográfico fuerte. Los tres corren con los mismos créditos de Moosky.
¿Puede R2V mantener el mismo personaje en varios clips?
Sí — de eso se trata. Reutiliza la misma imagen de referencia como semilla de cada clip del proyecto y el modelo preserva la cara y el estilo. Para escenas de diálogo, añade una referencia de voz para que el personaje suene consistente también.
¿Cuánto cuesta R2V en Moosky?
Las generaciones R2V se facturan en créditos como todo lo demás en Moosky (100 créditos por $1), y el coste exacto de cada clip aparece en el compositor antes de ejecutar. No hay suscripción y los créditos nunca caducan — pagas por los clips que de verdad generas.
¿Es ref2V lo mismo que R2V?
Sí — ref2v (también escrito ref2va) es solo la grafía abreviada de referencia a video que MiniMax usa para el modo de H3, y quienes buscan la usan para toda la categoría. Cada clip de esta página es un clip ref2v: el motor que elijas acondiciona el render sobre tus referencias. Si tu toma vive o muere por el diálogo hablado y una voz que se sostenga, abre la página MiniMax H3 Ref2V, que profundiza en ese modo; para trabajo de personaje entre motores, este hub es el punto de partida.
¿Puedo cambiar una cara en un video sin re-grabarlo?
Sí — eso es un recast, y corre sobre el mismo acondicionamiento por referencia que todo lo demás de aquí. Sube una foto de cara clara y consentida más la dirección de la toma original (storyboard, blocking, cámara), y un motor R2V re-renderiza la escena con esa identidad fija; borra la comparación de casting barato en LTX 2.5 y luego pasa la toma buena a hero en Wan 3.0 o Seedance. La regla de consentimiento es firme: usa tu propia cara o una con permiso explícito, y etiqueta los recasts de pitch o previz como generados.
Divulgación
Moosky AI es una plataforma independiente y revendedora de acceso a modelos de IA. Los nombres de productos, modelos y empresas que aparecen en esta página pertenecen a sus respectivos titulares. Moosky AI no está oficialmente afiliada, patrocinada ni avalada por esos proveedores salvo que se indique expresamente. El contenido de la página, los ejemplos y las previsualizaciones pueden incluir contenido asistido por IA y sintético.