R2V, explicado
¿Qué es R2V?
De referencia a vídeo,
explicado en buen romance.
R2V significa de referencia a vídeo: el modo de generación con IA en que el modelo renderiza un clip completamente nuevo manteniéndose condicionado por tus archivos de referencia — una cara, un producto, una hoja de estilo, un clip de movimiento. Aquí está la definición, en qué se diferencia de texto a vídeo e imagen a vídeo, y dónde probarlo.
Opciones de modelos
Elegí el flujo que mejor se ajusta a tu proyecto
Empezá con un prompt, sumá referencias si hace falta y elegí el camino de generación que coincida con el resultado que buscás.
Wan 3.0 R2V
El modo de referencia de Wan 3.0 es la forma más completa de sentir lo que hace R2V: sube caras y fotos de vestuario, un clip de movimiento y tomas de voz opcionales, y Wan reinterpreta tu escena nueva cargando la identidad, el movimiento y la sincronía.
El hub de referencia a vídeo
Tres motores R2V corren en Moosky — diálogo primero, movimiento primero y encuadre primero. El hub los pone lado a lado para que elijas por plano.
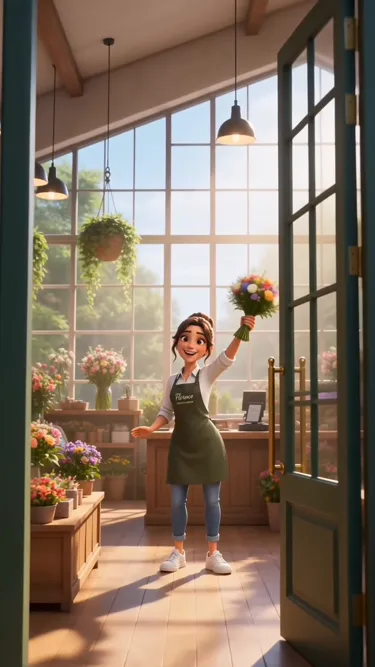
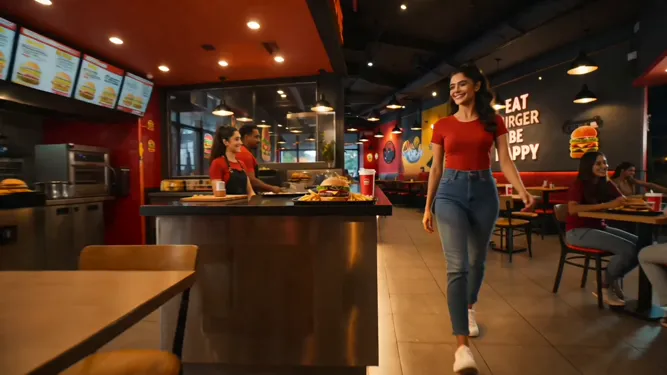
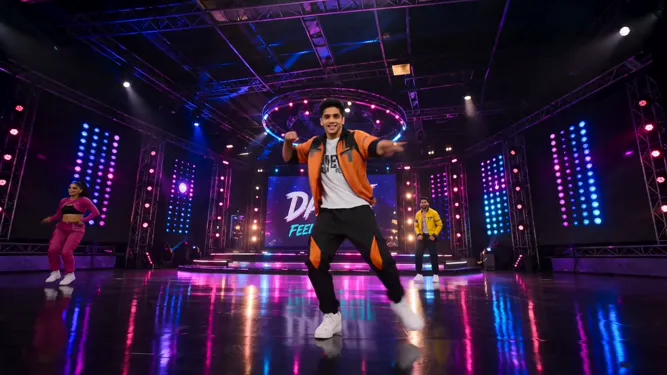
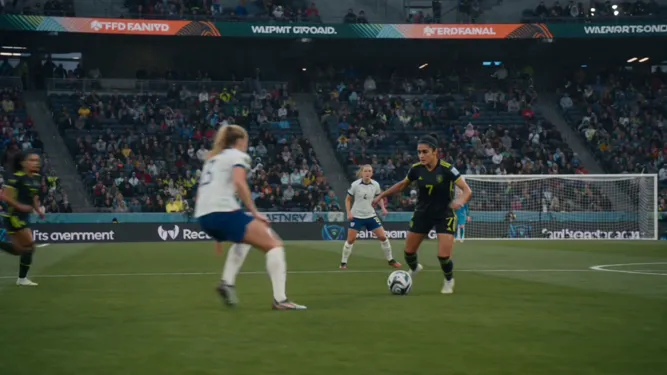
Ejemplos de resultados
Clips hechos con referencias en Moosky
Resultados reales de generación condicionada por referencia — el mismo modo que esta página explica.
Por qué usarlo en Moosky AI
Herramientas potentes. Experiencia sin fricción.
La identidad vive en tus subidas
Las referencias, no los adjetivos, llevan al personaje — la misma cara, producto y estilo sobreviven cada toma de todo el proyecto.
El mismo reparto, escenas nuevas
Las referencias definen quién aparece, no cómo se arma el cuadro, así el personaje puede entrar en cualquier escenario, ángulo o vestuario que pidas después.
Movimiento que puedes pedir prestado
En los motores R2V que aceptan referencias de vídeo, un clip corto de la acción que quieres dirige el movimiento del modelo en vez de su imaginación.
La voz viaja con la cara
Adjunta una referencia de audio en los motores compatibles y la línea actuada mantiene ese timbre, así el personaje suena tan constante como se ve.
El prompt se queda simple
Con el reparto cerrado por referencias, tu prompt solo tiene que describir la escena — escenario, acción, cámara — en vez de reinventar al sujeto en cada run.
Paga por clip
R2V corre con créditos Moosky, cotizados por generación en el composer antes de renderizar nada. Sin suscripción, y las repeticiones con los mismos ajustes cuestan la misma tarifa fija.
Cómo funciona
Cuatro pasos de archivos de referencia a clip terminado
Reúne tus referencias
Junta una o dos fotos claras de la cara, producto o look a llevar — más archivos opcionales de movimiento y voz.
Súbelas y etiquétalas
Dile al modelo qué lleva cada archivo — Imagen 1 es la cara, Vídeo 1 es el movimiento — para que las referencias cumplan sus papeles.
Describe la escena nueva
Pide el plano que quieres: escenario, acción, cámara. Las referencias sostienen el reparto; tus palabras dirigen la escena.
Renderiza y repite barato
Elige un motor, mira la cotización en créditos y genera. Las buenas salen; las repeticiones cuestan la misma tarifa fija.
Qué significa R2V, en una respuesta honesta
R2V es la abreviatura de de referencia a vídeo: un render de IA condicionado por archivos que tú aportas — una cara, un producto, una hoja de estilo, un clip de movimiento — en vez de una descripción que reinventa al sujeto en cada toma. Quien teclea ai r2v o pregunta qué significa r2v hace una sola pregunta: ¿cómo evita el modelo que el reparto derive? La respuesta son tus subidas.
La escalera de decisión es simple. Texto a vídeo encaja con clips únicos sin necesidad de continuidad. Imagen a vídeo anima una foto fija — la imagen misma se vuelve el fotograma de apertura. R2V es el carril de los proyectos: las referencias definen quién aparece, el prompt define qué pasa, y el mismo personaje sobrevive toma tras toma en escenarios y ángulos nuevos.
En Moosky, Wan 3.0 R2V es el ejemplo más completo del modo: sube caras, fotos de vestuario, un clip de movimiento y tomas de voz opcionales, y el modelo reinterpreta tu escena nueva cargándolo todo, facturado por clip en créditos con el precio cotizado antes de ejecutar nada.
Créditos
Precio simple y honesto
R2V factura en créditos Moosky (100 por $1) como cualquier otra generación — el composer cotiza el coste exacto según tu duración y resolución antes de que nada corra, y no se cobra nada por una toma que descartas antes de ejecutarla.

Más de Moosky AI
Explorá toda la suite de herramientas de IA.
Preguntas frecuentes
¿Qué significan las siglas R2V en generación de vídeo IA?
R2V significa de referencia a vídeo. Nombra un modo de generación con IA en que el modelo renderiza un clip nuevo condicionándose en archivos de referencia que tú aportas — fotos de una cara o producto, hojas de estilo, clips de movimiento, a veces tomas de voz. El prompt sigue escribiendo la escena; las referencias deciden quién y qué aparece en ella, y quedan cerradas de la primera toma a la última.
¿En qué se diferencia R2V de texto a vídeo?
En texto a vídeo la descripción lo es todo: pide el mismo personaje dos veces y obtendrás dos personas distintas, porque el modelo inventa al sujeto de cero en cada run. R2V saca la identidad del prompt y la mete en tus subidas, así el reparto deja de derivar. Texto a vídeo sigue siendo la herramienta correcta para clips únicos sin continuidad — R2V se gana su lugar en cuanto un proyecto necesita la misma cara en muchos planos.
¿Cuándo uso R2V en vez de imagen a vídeo?
Imagen a vídeo toma una foto fija y la anima — la imagen misma se vuelve el plano de apertura, composición incluida. Elígelo cuando un fotograma es exactamente lo que quieres. Elige R2V cuando el personaje importa más que el encuadre: las referencias definen identidad y no maquetación, así puedes poner al mismo sujeto en escenas, ángulos y vestuarios nuevos y mantenerlo reconociblemente él en todos los clips.
¿Qué subo como referencia R2V?
Empieza con una o dos fotos claras de la cara, producto o estilo que quieres llevar — de frente, bien iluminadas, sin ruido detrás del sujeto. Desde ahí puedes añadir fotos de vestuario o utilería, un clip corto del movimiento que quieres que el modelo copie y, en motores compatibles, tomas de audio para la voz. La mayoría de equipos logran una consistencia útil con dos o tres buenas imágenes; kits de referencia más largos afinan los bordes.
¿R2V es lo mismo que ref2v?
Sí. Ref2v es solo otra abreviatura de referencia a vídeo, popularizada por la grafía que MiniMax usa para su modo R2V, y quien busca mezcla las dos libremente. Ambas abreviaturas describen la misma capacidad: un render condicionado por tus archivos de referencia. También verás reference-to-video escrito completo en fichas de modelo y nombres de modo — cada grafía apunta a la misma idea.
¿Cómo se ve un flujo R2V en Moosky?
Sube tus referencias, etiqueta qué lleva cada archivo (cara, vestuario, movimiento, voz) y describe el plano nuevo en lenguaje natural — escenario, acción, cámara. Elige un motor R2V, y el composer cotiza el coste en créditos según tu duración y resolución antes de renderizar nada. Repeticiones y ediciones cuestan la misma tarifa fija por clip, sin suscripción detrás.
¿Dónde puedo probar R2V?
Abre el composer de Wan 3.0 R2V para el flujo de kit de referencia con transferencia de movimiento y audio nativo, o empieza en el hub de referencia a vídeo para comparar los motores lado a lado antes de elegir. Los dos corren con un único saldo de créditos de Moosky, así cambiar de modelo a mitad de proyecto no cuesta nada salvo los créditos que el propio clip usa.
Divulgación
Moosky AI es una plataforma independiente y revendedora de acceso a modelos de IA. Los nombres de productos, modelos y empresas que aparecen en esta página pertenecen a sus respectivos titulares. Moosky AI no está oficialmente afiliada, patrocinada ni avalada por esos proveedores salvo que se indique expresamente. El contenido de la página, los ejemplos y las previsualizaciones pueden incluir contenido asistido por IA y sintético.