R2V, explicado
O que é R2V?
De referência a vídeo,
explicado em bom português.
R2V significa de referência a vídeo: o modo de geração com IA em que o modelo renderiza um clipe totalmente novo ficando condicionado aos seus arquivos de referência — um rosto, um produto, uma folha de estilo, um clipe de movimento. Aqui vai a definição, como difere de texto para vídeo e imagem para vídeo, e onde testar.
Opções de modelos
Escolha o fluxo que combina com a sua cena
Comece com um prompt, adicione referências quando precisar e escolha o caminho de geração que corresponda ao resultado.
Wan 3.0 R2V
O modo de referência do Wan 3.0 é a forma mais completa de sentir o que R2V faz: envie rostos e fotos de figurino, um clipe de movimento e takes de voz opcionais, e o Wan reencena sua nova cena carregando a identidade, o movimento e a sincronia.
O hub de referência para vídeo
Três motores R2V rodam no Moosky — diálogo primeiro, movimento primeiro e enquadramento primeiro. O hub põe as faixas lado a lado para você escolher por plano.
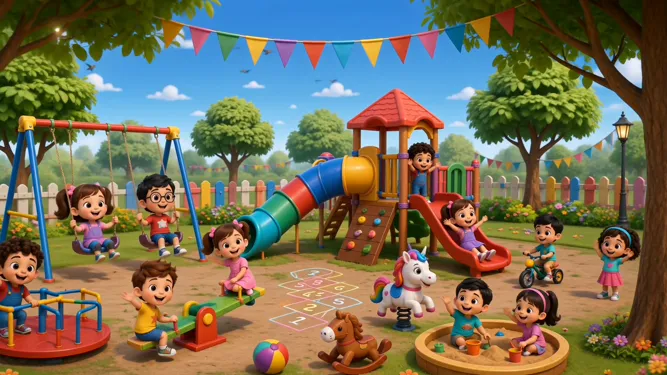
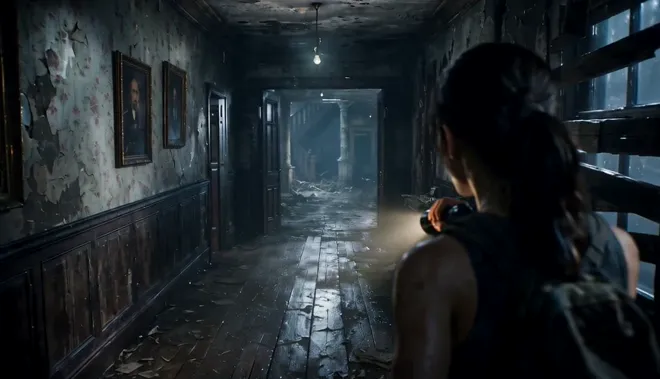
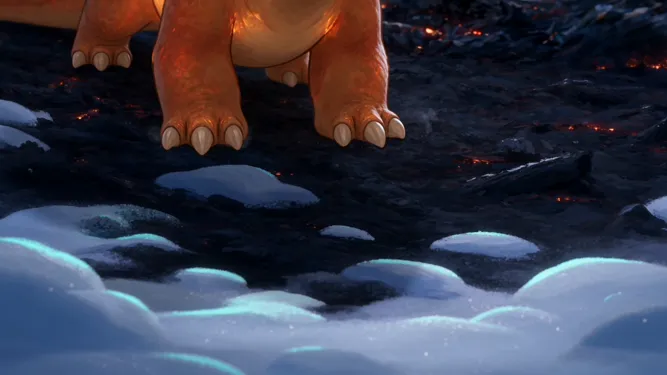
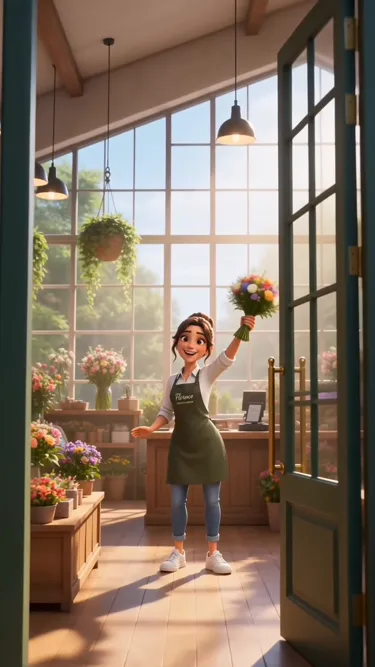
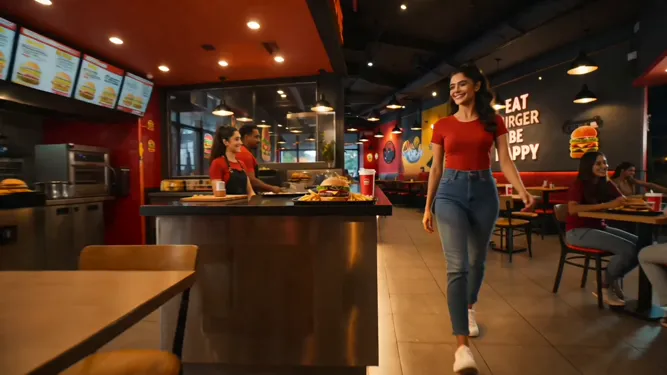
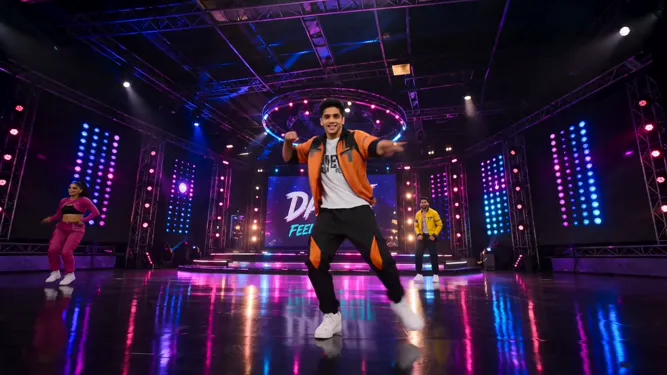
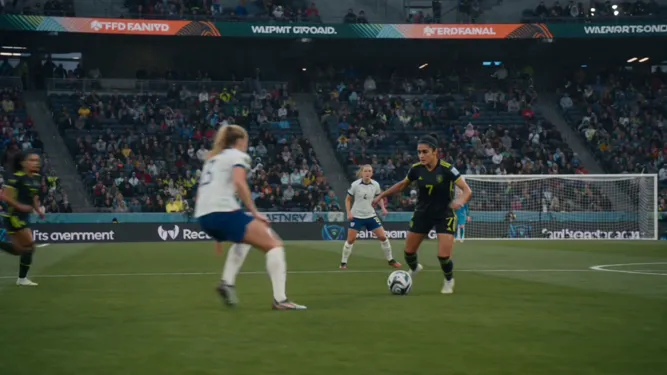
Exemplos de resultados
Clipes feitos com referências no Moosky
Saídas reais de geração condicionada por referência — o mesmo modo que esta página explica.
Por que usar no Moosky AI
Ferramentas poderosas. Experiência sem atrito.
A identidade mora nos seus uploads
Referências, não adjetivos, carregam o personagem — o mesmo rosto, produto e estilo sobrevivem a cada tomada do projeto.
Mesmo elenco, novas cenas
As referências definem quem aparece, não como o quadro é montado, então o personagem pode entrar em qualquer cenário, ângulo ou roupa que você pedir a seguir.
Movimento que você pode pegar emprestado
Nos motores R2V que aceitam referências de vídeo, um clipe curto da ação desejada dirige o movimento do modelo em vez da imaginação dele.
A voz vai junto com o rosto
Anexe uma referência de áudio nos motores compatíveis e a fala atuada mantém aquele timbre, então o personagem soa tão consistente quanto parece.
O prompt fica simples
Com o elenco travado pelas referências, seu prompt só precisa descrever a cena — cenário, ação, câmera — em vez de reinventar o sujeito a cada run.
Pague por clipe
R2V roda com créditos Moosky, cotados por geração no composer antes de renderizar qualquer coisa. Sem assinatura, e refações nos mesmos ajustes custam a mesma tarifa fixa.
Como funciona
Quatro passos dos arquivos de referência ao clipe pronto
Reúna suas referências
Junte uma ou duas fotos nítidas do rosto, produto ou visual a carregar — mais arquivos opcionais de movimento e voz.
Envie e rotule cada um
Diga ao modelo o que cada arquivo carrega — Imagem 1 é o rosto, Vídeo 1 é o movimento — para as referências cumprirem seus papéis.
Descreva a nova cena
Peça o plano que quer: cenário, ação, câmera. As referências seguram o elenco; suas palavras dirigem a cena.
Renderize e refaça barato
Escolha um motor, veja a cotação em créditos e gere. As boas saem; refações custam a mesma tarifa fixa.
O que R2V significa, numa resposta honesta
R2V é a abreviação de de referência a vídeo: um render de IA condicionado a arquivos que você fornece — um rosto, um produto, uma folha de estilo, um clipe de movimento — em vez de uma descrição que reinventa o sujeito a cada tomada. Quem digita ai r2v ou pergunta o que significa r2v faz uma única pergunta: como o modelo impede o elenco de desandar? A resposta são os seus uploads.
A escada de decisão é simples. Texto para vídeo serve para clipes únicos sem necessidade de continuidade. Imagem para vídeo anima uma foto fixa — a imagem vira o quadro de abertura. R2V é a faixa dos projetos: as referências definem quem aparece, o prompt define o que acontece, e o mesmo personagem sobrevive tomada após tomada em novos cenários e ângulos.
No Moosky, o Wan 3.0 R2V é o exemplo mais completo do modo: envie rostos, fotos de figurino, um clipe de movimento e takes de voz opcionais, e o modelo reencena sua nova cena carregando tudo isso, cobrado por clipe em créditos com o preço cotado antes de rodar qualquer coisa.
Cobrança por créditos
Preço simples e transparente
R2V cobra em créditos Moosky (100 por $1) como toda geração — o composer cotiza o custo exato pela duração e resolução do seu clipe antes de rodar qualquer coisa, e nada é cobrado por uma tomada que você descarta antes de executar.

Mais da Moosky AI
Conheça a suíte completa de ferramentas de IA.
Perguntas frequentes
O que a sigla R2V significa na geração de vídeo IA?
R2V significa de referência a vídeo. Nomeia um modo de geração com IA em que o modelo renderiza um clipe novo condicionando-se a arquivos de referência que você envia — fotos de um rosto ou produto, folhas de estilo, clipes de movimento, às vezes takes de voz. O prompt ainda escreve a cena; as referências decidem quem e o que aparece nela, e ficam travadas da primeira à última tomada.
Como R2V difere de texto para vídeo?
Em texto para vídeo a descrição é tudo: peça o mesmo personagem duas vezes e você terá duas pessoas diferentes, porque o modelo inventa o sujeito do zero a cada run. R2V tira a identidade do prompt e a põe nos seus uploads, então o elenco para de desandar. Texto para vídeo ainda é a ferramenta certa para clipes únicos sem continuidade — R2V ganha o lugar dele no momento em que um projeto precisa do mesmo rosto em muitos planos.
Quando usar R2V em vez de imagem para vídeo?
Imagem para vídeo pega uma foto fixa e a anima — a imagem vira o plano de abertura, composição inclusa. Escolha-o quando um quadro está exatamente certo. Escolha R2V quando o personagem importa mais que o enquadramento: referências definem identidade em vez de layout, então você pode pôr o mesmo sujeito em novas cenas, ângulos e roupas e mantê-lo reconhecivelmente ele próprio em todos os clipes.
O que devo enviar como referência R2V?
Comece com uma ou duas fotos nítidas do rosto, produto ou estilo que quer carregar — de frente, bem iluminadas, sem bagunça atrás do sujeito. Daí você pode adicionar fotos de figurino ou adereço, um clipe curto do movimento que quer que o modelo copie e, em motores compatíveis, takes de áudio para a voz. A maioria dos times consegue consistência utilizável com duas ou três boas imagens; kits de referência maiores afinam as bordas.
R2V é a mesma coisa que ref2v?
Sim. Ref2v é só uma grafia alternativa de referência para vídeo, popularizada pela escrita que o MiniMax usa para seu modo R2V, e quem busca mistura as duas livremente. Ambas as abreviações descrevem a mesma capacidade: um render condicionado aos seus arquivos de referência. Você também verá reference-to-video por extenso em fichas de modelo e nomes de modo — cada grafia aponta para a mesma ideia.
Como é um fluxo R2V no Moosky?
Envie suas referências, rotule o que cada arquivo carrega (rosto, roupa, movimento, voz) e descreva o novo plano em linguagem natural — cenário, ação, câmera. Escolha um motor R2V, e o composer cotiza o custo em créditos pela duração e resolução do seu clipe antes de renderizar qualquer coisa. Refações e edições custam a mesma tarifa fixa por clipe, sem assinatura por trás.
Onde posso testar R2V?
Abra o composer do Wan 3.0 R2V para o fluxo de kit de referência com transferência de movimento e áudio nativo, ou comece pelo hub de referência para vídeo para comparar os motores lado a lado antes de escolher. Os dois rodam num único saldo de créditos do Moosky, então trocar de modelo no meio do projeto não custa nada além dos créditos que o próprio clipe usa.
Divulgação
A Moosky AI é uma plataforma independente e revendedora de acesso a modelos de IA. Os nomes de produtos, modelos e empresas exibidos nesta página pertencem aos respectivos titulares. A Moosky AI não é oficialmente afiliada, patrocinada nem endossada por esses provedores, salvo quando indicado expressamente. O conteúdo da página, os exemplos e as pré-visualizações podem incluir conteúdo assistido por IA e sintético.