R2V, expliqué
Qu'est‑ce que R2V ?
De la référence à la vidéo,
expliqué simplement.
R2V veut dire « de la référence à la vidéo » : le mode de génération où le modèle produit un plan entièrement neuf tout en restant conditionné par vos fichiers de référence — un visage, un produit, une planche de style, un plan de mouvement. Voici la définition, ce qui le distingue du texte-vers-la-vidéo et de l'image-vers-la-vidéo, et où l'essayer.
Options de modèles
Choisissez le flux qui correspond à votre scène
Commencez avec un prompt, ajoutez des références au besoin, puis choisissez la voie de génération qui correspond au résultat.
Wan 3.0 R2V
Le mode référence de Wan 3.0 est la façon la plus complète de sentir ce que fait R2V : envoyez visages et plans de costume, un plan de mouvement et des prises de voix facultatives, et Wan rejoue votre scène en gardant l'identité, le mouvement et la synchro.
Le hub de la référence vers la vidéo
Trois moteurs R2V tournent sur Moosky — dialogue d'abord, mouvement d'abord, cadrage d'abord. Le hub les aligne côte à côte pour que vous choisissiez plan par plan.
Exemples de résultats
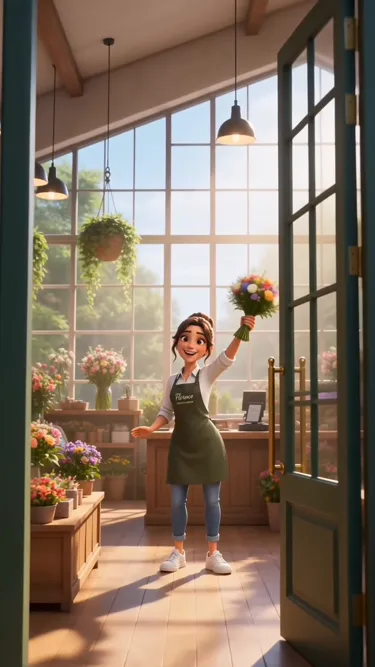
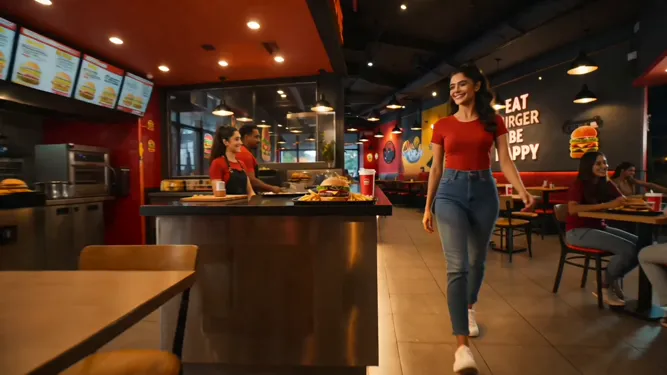
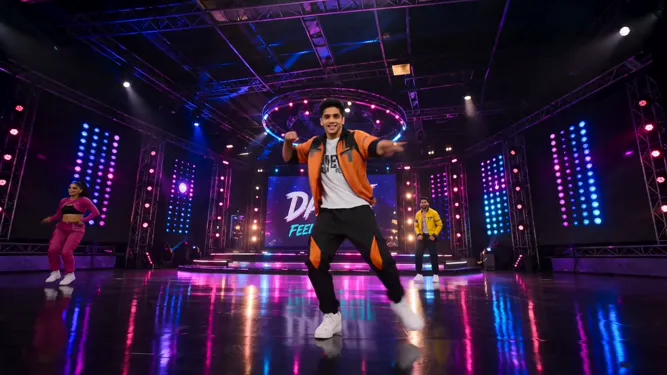
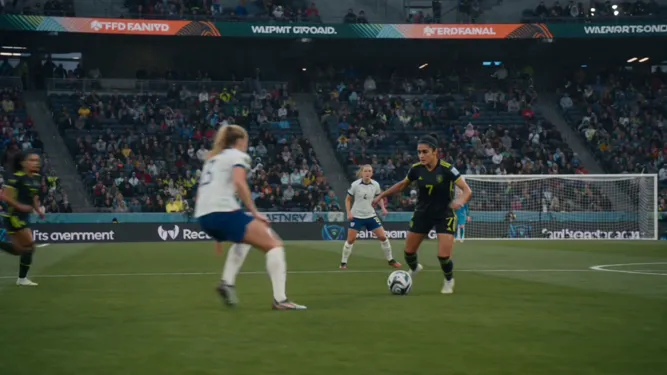
Des plans créés à partir de références sur Moosky
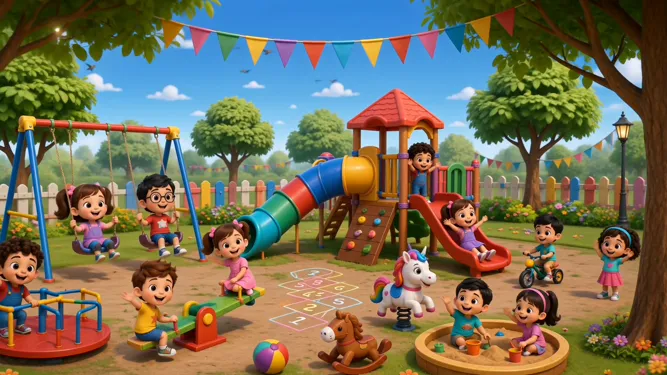
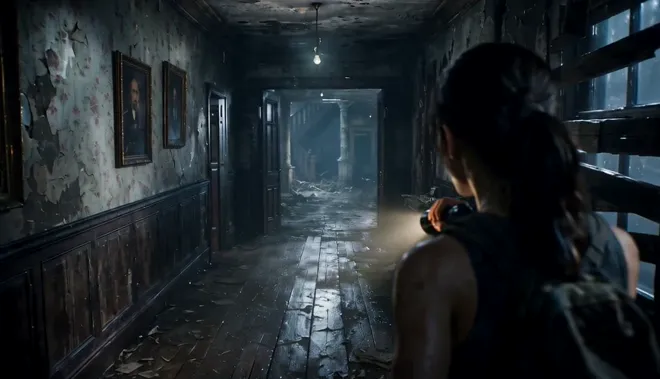
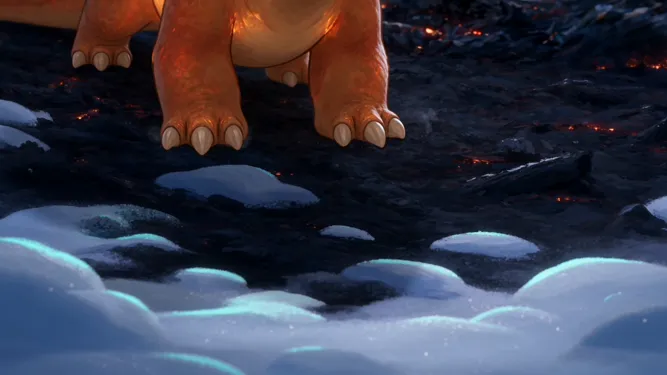
Des sorties réelles de la génération guidée par références — le même mode expliqué ici.
Pourquoi l’utiliser sur Moosky AI
Des outils puissants. Une expérience sans accroc.
L'identité vit dans vos envois
Ce sont les références, pas les adjectifs, qui portent le personnage — le même visage, le même produit et le même style survivent à chaque prise du projet.
Même casting, nouvelles scènes
Les références définissent qui apparaît, pas comment l'image est construite : le personnage peut entrer dans tout décor, angle ou costume que vous décrirez ensuite.
Du mouvement que l'on emprunte
Sur les moteurs R2V qui acceptent des références vidéo, un court plan de l'action voulue pilote le mouvement du modèle plutôt que son imagination.
La voix suit le visage
Ajoutez une référence audio sur les moteurs compatibles et la réplique jouée garde ce timbre : le personnage sonne aussi cohérent qu'il le paraît.
Le prompt reste simple
Le casting verrouillé par les références, votre prompt n'a plus qu'à décrire la scène — décor, action, caméra — au lieu de réinventer le sujet à chaque lancement.
Payez au plan
Les lancements R2V tournent aux crédits Moosky, chiffrés par génération dans le compositeur avant tout rendu. Sans abonnement, et les reprises aux mêmes réglages coûtent le même tarif fixe.
Comment ça marche
Quatre étapes, des références au plan fini
Réunissez vos références
Rassemblez une ou deux photos nettes du visage, du produit ou du look à porter — plus, si vous voulez, des fichiers de mouvement et de voix.
Envoyez et annotez
Indiquez au modèle ce que porte chaque fichier — Image 1 pour le visage, Vidéo 1 pour le mouvement — pour que chaque référence joue son rôle.
Décrivez la nouvelle scène
Écrivez le plan voulu : décor, action, caméra. Les références tiennent le casting ; vos mots mettent en scène.
Lancez et reprenez à bas coût
Choisissez un moteur, surveillez le devis en crédits, générez. Les plans gardés sortent ; les reprises coûtent le même tarif fixe.
Ce que veut dire R2V, en une réponse honnête
R2V est le raccourci de « reference to video », de la référence à la vidéo : un rendu d'IA conditionné par des fichiers que vous fournissez — un visage, un produit, une planche de style, un plan de mouvement — plutôt que par une description qui réinvente le sujet à chaque prise. Ceux qui tapent ai r2v ou cherchent ce que R2V veut dire posent une seule question : comment le modèle empêche-t-il le casting de dériver ? La réponse, ce sont vos fichiers.
L'échelle de décision est simple. Le texte vers la vidéo convient aux plans isolés sans besoin de continuité. L'image vers la vidéo anime une photo fixe — l'image elle-même devient le plan d'ouverture. R2V est la voie des projets : les références définissent qui apparaît, le prompt définit ce qui se passe, et le même personnage survit prise après prise dans des décors et des angles nouveaux.
Sur Moosky, Wan 3.0 R2V est l'exemple le plus complet de ce mode : envoyez visages, plans de costume, un plan de mouvement et des prises de voix facultatives, et le modèle rejoue votre scène en portant tout cela, facturé au plan en crédits avec le prix annoncé avant que rien ne lance.
Crédits
Une tarification simple et honnête
R2V se facture en crédits Moosky (100 par dollar) comme toute génération — le compositeur chiffre le coût exact d'après la durée et la résolution de votre plan avant tout rendu, et rien n'est facturé pour une prise supprimée avant lancement.
Plus de Moosky AI
Explorez toute notre suite d’outils IA.
Questions fréquentes
Que signifie R2V en génération vidéo par IA ?
R2V signifie « de la référence à la vidéo ». Le nom désigne un mode de génération où le modèle produit un plan neuf en restant conditionné par des fichiers de référence que vous fournissez — photos d'un visage ou d'un produit, planches de style, plans de mouvement, parfois prises de voix. Le prompt écrit toujours la scène ; les références décident qui et quoi y apparaît, et elles restent verrouillées de la première prise à la dernière.
En quoi R2V diffère du texte vers la vidéo ?
En texte vers la vidéo, la description est tout : demandez deux fois le même personnage et vous obtenez deux personnes différentes, car le modèle invente le sujet à chaque lancement. R2V déplace l'identité du prompt vers vos fichiers, et le casting cesse de dériver. Le texte vers la vidéo reste le bon outil pour un plan isolé sans besoin de continuité — R2V prouve sa valeur dès qu'un projet exige le même visage dans plusieurs plans.
Quand utiliser R2V plutôt que l'image vers la vidéo ?
L'image vers la vidéo prend une photo fixe et l'anime — l'image elle-même devient le plan d'ouverture, cadrage compris. Choisissez-la quand un cadre est exactement bon. Choisissez R2V quand le personnage compte plus que le cadrage : les références définissent l'identité et non la composition, vous pouvez donc placer le même sujet dans de nouvelles scènes, angles et costumes en le gardant reconnaissable sur toute la série de plans.
Quoi envoyer comme référence R2V ?
Commencez par une ou deux photos nettes du visage, du produit ou du style à porter — de face, bien éclairées, sans désordre derrière le sujet. Ajoutez ensuite des plans de costume ou d'accessoires, un court plan du mouvement que vous voulez voir emprunté et, sur les moteurs compatibles, des prises audio pour la voix. La plupart des équipes obtiennent une cohérence exploitable avec deux ou trois bonnes images ; des kits de référence plus longs affinent les contours.
R2V est-il la même chose que ref2v ?
Oui. Ref2v n'est qu'une graphie alternative de « de la référence à la vidéo », popularisée par l'orthographe que MiniMax emploie pour son mode R2V, et les chercheurs mélangent librement les deux. Les deux abréviations décrivent la même capacité : un rendu conditionné par vos fichiers de référence. Vous verrez aussi reference-to-video écrit en toutes lettres sur les fiches de modèles et les noms de modes — chaque graphie pointe vers la même idée.
À quoi ressemble un flux R2V sur Moosky ?
Envoyez vos références, annotez ce que porte chaque fichier (visage, tenue, mouvement, voix), puis décrivez le nouveau plan en langage courant — décor, action, caméra. Choisissez un moteur R2V, et le compositeur chiffre le coût en crédits d'après la durée et la résolution avant tout rendu. Les reprises et retouches coûtent le même tarif fixe au plan, sans abonnement derrière.
Où essayer R2V ?
Ouvrez le compositeur Wan 3.0 R2V pour le flux kit de références avec transfert de mouvement et audio natif, ou partez du hub de la référence vers la vidéo pour comparer les moteurs côte à côte avant de choisir. Les deux tournent sur un seul solde de crédits Moosky : changer de modèle en cours de projet ne coûte que les crédits du plan lui-même.
Divulgation
Moosky AI est une plateforme indépendante et revendeuse d’accès à des modèles d’IA. Les noms de produits, de modèles et d’entreprises affichés sur cette page appartiennent à leurs titulaires respectifs. Moosky AI n’est officiellement affiliée, parrainée ni endossée par ces fournisseurs sauf mention expresse. Le contenu de la page, les exemples et les aperçus peuvent inclure du contenu assisté par IA et synthétique.