A interface do app está em inglês por agora.
Guia de campo Moosky AI
Como fazer um vídeo a partir de uma referência com IA (r2v): o guia do workflow
Guia em português para gerar vídeo com IA a partir de um vídeo de referência (r2v): os motores, os limites de 15s/30s e a conta honesta de créditos por take.
Nesta página
Como fazer um vídeo a partir de uma referência com IA (r2v): o guia do workflow
Gerar vídeo com IA a partir de uma referência — o que os americanos chamam de reference-to-video, ou r2v — é quando você não descreve a cena que quer: você mostra. Em vez de implorar para o modelo inventar "uma dançarina girando num galpão industrial com luz lateral", você anexa um clipe de três segundos com exatamente o movimento que você quer, escreve o que muda, e recebe um take novo executando aquela coreografia. A descrição descreve um plano; a referência carrega um plano inteiro — velocidade, peso, trajetória de câmera, o jeito que o cabelo acompanha o giro.
Este guia é o workflow completo em português: quando uma referência vale o esforço, quais são os limites duros de cada motor, como escrever o prompt "amarrado" na referência, e quanto tudo isso custa em créditos. Todo número vem da própria configuração de cobrança viva da Moosky: cada crédito custa US$ 0,01 (pacote mínimo de US$ 5 = 500 créditos), o cadastro entrega 10 créditos de teste, e o preço fechado do seu take aparece na tela antes do botão de gerar.
Quando a referência ganha do prompt puro
Texto puro (o modo clássico de gerar vídeo com IA) resolve o que é genérico: drone sobre montanha, chuva em rua neon, timelapse de nuvens. Para essas cenas, a palavra carrega. A referência entra quando o que importa no plano não cabe em palavra:
- Consistência de personagem. O mesmo rosto, roupa e corpo precisam aparecer em cinco takes seguidos. "Uma mulher de jaqueta vermelha" nunca sai igual cinco vezes; uma referência de imagem trava a identidade.
- Consistência de espaço. Uma loja, um palco, um quarto que precisa ler como o MESMO lugar em cortes diferentes. A imagem do espaço carrega a arquitetura que o prompt inventaria de novo a cada render.
- Sensação de movimento. Aqui entra a vídeo-referência, o coração do r2v: um clipe curto condiciona o modelo ao movimento e ao ritmo dele. Você tem a batida gravada? Anexe o trecho e mande outro sujeito dançá-la.
- Voz. Referências de áudio soltas (até 5) amarram uma voz a um personagem: você anexa a amostra, escreve a fala, e não depende do modelo "escalar" uma voz qualquer.
Se nada disso importa pro seu plano, r2v não compra nada — e o prompt simples sai mais barato e mais rápido.
Os motores de r2v da Moosky e a escolha honesta
A plataforma roda três motores de referência num único saldo de créditos — o hub de referência para vídeo tem a linha completa com exemplos ao vivo:
- Wan 3.0 R2V — o motor padrão para movimento e câmera: aceita até 10 imagens de referência, 5 vídeos de referência e 5 áudios soltos, com saída em até 1080p e 30 segundos. É o composer de entrada quando o plano é sobre movimento transferido de um clipe — câmera na mão, giro, coreografia.
- MiniMax H3 Ref2V — a raia do diálogo: quando o personagem fala, é ele que segura voz por referência e lábios sincronizados com a fala escrita. Barato em clipe curto (rascunhos em 768P giram em torno de 10 créditos por segundo de saída; o valor exato aparece no composer antes de rodar).
- Seedance 2.0 R2V — meio-termo cinematográfico, forte em enquadramento.
Este guia é o workflow do Wan 3.0 R2V, o composer de referência com vídeo, porque é nele que o vídeo-referência (e não só a foto) dirige o resultado. O caminho do MiniMax fala por folha de referências e diálogo é outro guia: MiniMax H3 Ref2V passo a passo — e se a sua dúvida antes do fluxo é se o modelo vale o crédito, a decisão de compra em português responde com a conta aberta.
Os limites duros — e a pegadinha dos 30 segundos
O composer do Wan 3.0 R2V aplica travas no runtime. Saber antes evita crédito queimado:
| Entrada | Limite |
|---|---|
| Imagens de referência | 10 |
| Vídeos de referência | 5 |
| Total de referências visuais | 15 |
| Áudios soltos | 5 |
| Duração somada dos vídeos de referência | 15 segundos |
| Duração somada dos áudios | 15 segundos |
| Segundos de vídeo de entrada + segundos de saída | 30 no total |
A última linha é a que pega todo mundo: os segundos do seu clipe de referência saem do MESMO orçamento de 30 segundos do resultado. Anexou um vídeo de 11 segundos? A saída é truncada em 19 segundos. Anexou um clipe de 28 segundos? Ele nem passa do limite de 15 s por clipe — a execução é rejeitada antes de gastar crédito. Corte o vídeo-referência no osso antes de subir: três segundos bem escolhidos dirigem o modelo tão bem quanto onze, e devolvem orçamento pro seu take final.
Passo 1 — Suba as referências e conte na ordem do modelo
Abra o composer e anexe na ordem em que quer que sejam lidas: a primeira imagem é a Imagem 1, o primeiro vídeo é o Vídeo 1, o primeiro áudio é o Áudio 1 — contados por tipo, mesmo quando você intercala os uploads. A ordem é decisão criativa, não organização: é por esses rótulos que o prompt vai chamar cada material.
O que faz uma referência merecer o slot:
- Personagem: um sujeito claramente visível, luz uniforme, no enquadramento que a saída deve executar (close de rosto gera close de rosto; corpo inteiro gera corpo inteiro). Se a identidade precisa sobrevirar a giro, suba um segundo ângulo como Imagem 2.
- Objeto e espaço: imagens limpas, sem obstrução. Um produto cortado meio fora de quadro não ensina nada ao modelo sobre ele.
- Movimento: o clipe mais curto que contém a batida desejada, sujeito único, sem cortes. Lembre do teto de 15 segundos somados e da conta de 30 com a saída.
- Voz: wav ou mp3 somando menos de 15 segundos. Anexe a amostra e escreva a fala entre aspas — ela gruda no Áudio N.
Passo 2 — Escreva o prompt amarrado nos rótulos
A fórmula oficial é referência + ação + cena + falas entre aspas (opcional) + música de fundo (opcional), em português mesmo ou inglês, sem JSON, sem markdown. Duas formas de amarrar funcionam: direta ("a dançarina do Vídeo 1 atravessa o mercado da Imagem 2") ou rótulo mais objeto ("o entregador do Vídeo 1 cruza o saguão da Imagem 3"). Regras que poupam crédito:
- Só use rótulos que você anexou de verdade. Citar "Imagem 4" com três imagens no ar é como se inventa elemento.
- Não rotule tempos internos como Imagem N. Dentro do take os planos são Plano 1, Plano 2 — com carimbo de tempo se houver corte.
- Fale entre aspas é preservada palavra por palavra. Se o clipe não tem fala, escreva "No dialogue." — sem isso o modelo escala uma. Se não quer trilha, "No background music."
- Amarre cada Áudio N ao personagem que fala; não invente voz pra quem não tem referência.
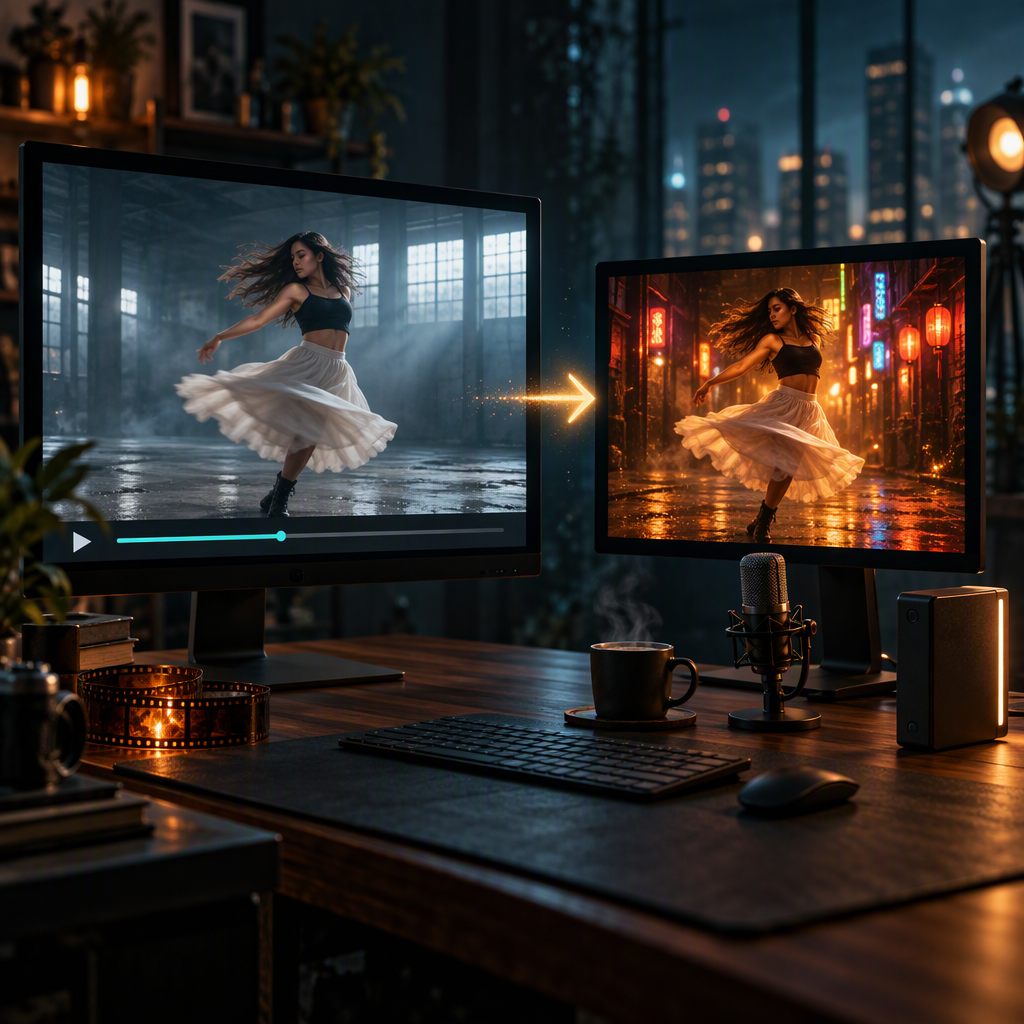
O exemplo worked deste guia (escolhido para não repetir os guias irmão): um clipe de três segundos de uma dançarina girando num galpão frio, no Vídeo 1, e uma foto de um beco neon na Imagem 2. O prompt:
Vídeo 1 atravessa o beco da Imagem 2, mantendo o giro com a saia esvoaçando, rindo sem falar, câmera na mão acompanhando, luz âmbar de poste. No dialogue. No background music.
Três segundos de referência deixam 27 de orçamento; você escolhe 8 segundos de saída em 480P para o primeiro teste — o composer mostra 62 créditos na tela antes do dispatch.
Quanto custa um take com referência (conta honesta)
O r2v do Wan 3.0 cobra igual ao resto da família Wan 3.0: valor por segundo que dobra a cada degrau de resolução — US$ 0,05/s em 480P, US$ 0,10/s em 720P, US$ 0,20/s em 1080P no custo do provedor, com a margem de 35% da plataforma aplicada, e nenhuma taxa fixa de reserva (a taxa de 10 créditos existe no composer de texto-para-vídeo, não aqui). A grade em créditos, com 100 = US$ 1:
| Duração do clipe | 480P | 720P | 1080P |
|---|---|---|---|
| 2s (mínimo) | 16 | 31 | 62 |
| 5s (padrão) | 39 | 77 | 154 |
| 10s | 77 | 154 | 308 |
| 15s | 116 | 231 | 462 |
| 30s (máximo, se as referências deixarem espaço) | 231 | 462 | 924 |
Três consequências práticas:
- A referência não cobra linha extra. Um take de 5 segundos custa 39 créditos em 480P com uma imagem anexada ou com catorze referências. Você paga o clipe que sai, não a direção que alimentou.
- O truncamento protege seu bolso, não só a API. Como os segundos do vídeo-referência comem o teto de 30, uma entrada longa demais capa sua saída em silêncio — confira o número na tela antes de disparar.
- Rascunho barato, final à parte. O motivo de existir do r2v é que a primeira tentativa genérica não ficou certa; o laço de rascunho (480P, 39 créditos os cinco segundos) é como você converge sem pagar 154 créditos por cada experimento em 1080P. A aritmética de repetir ou trocar de motor está na guia de custo por clipe utilizável.
Áudio nativo custa o mesmo ligado ou desligado, e falha de provedor estorna automaticamente: erro de render custa uma nova tentativa, não o crédito.
Quando ir além do Wan 3.0 R2V
Para fala, o MiniMax H3 é a escolha documentada (voz por referência e lábios no tempo da linha escrita) e a planilha de workflow do H3 Ref2V cobre aquele processo do upload à exportação. Para texto na tela — letreiro, embalagem com marca legível — nenhum motor cumpre bem; é limitação documentada da família, e vale gastar 39 créditos num teste antes de desenhar a cena em cima dela. Manter o MESMO personagem ao longo de um projeto inteiro é outra habilidade, com método próprio na guia de vídeos com personagem consistente; a comparação entre os modos (imagem para vídeo, texto para vídeo, vídeo de referência) está no guia conceito what is reference-to-video (r2v), hoje disponível em inglês. O passo a passo do composer em inglês, com a mesma grade de preços, está em how to steer a Wan 3.0 clip with a reference video.
Perguntas que chegam antes do primeiro crédito
Preciso pagar pelas referências? Não. Referência não tem preço próprio: a conta é a grade de duração × resolução acima, exibida antes do botão.
Quantos segundos de vídeo-referência eu subo? Os mais curtos que contenham a batida — três costuma bastar — lembrando que entrada e saída dividem os 30 segundos.
Serve para vídeo de música com lip-sync? Para fala curta e precisa, o MiniMax H3 é melhor documentado que o Wan; para coreografia e movimento, o Wan 3.0 R2V é o padrão.
Começo por onde com zero gasto? O cadastro dá 10 créditos grátis — não dá nem um take de rascunho em 1080P (são 154), mas o primeiro teste da primeira imagem de referência em 480P curto cabe na recarga mínima de US$ 5 (500 créditos) com folga para meia dúzia de iterações. A matemática do que é de graça de verdade em cada plataforma está na guia do gerador grátis.
A promessa do r2v é objetiva: você para de descrever o plano e começa a entregá-lo. Suba o clipe mais curto que segura a batida, nomeie as referências exatamente como as carregou, rascunhe em 480P por 39 créditos — e o número fechado aparece na tela antes de o render começar, toda vez.
Crie com a Moosky AI
Transforme ideias em produções prontas
Acesse os principais modelos de IA e fluxos de produção em um só lugar.
Experimente o Moosky AIComments
Comments are reviewed before they appear publicly.
Join the discussion — sign in or create an account to leave a comment.
No approved comments yet. Start the conversation.