دليل Moosky AI الميداني
ما هو الفيديو المرجعي بالذكاء الاصطناعي؟ كيف تختار بين R2V وتحويل الصورة إلى فيديو والنص إلى فيديو
دليل شراء الفيديو المرجعي بالذكاء الاصطناعي: كيف يختلف R2V عن تحويل الصورة إلى فيديو والنص إلى فيديو، ومتى تستعمل كلًّا منهما، وكم يكلف كل مقطع.
في هذه الصفحة
لديك فكرة مقطع وقرار تتخذه قبل أن تكتب حرفًا واحدًا في البرومبت: هل يحتاج النموذج إلى كلمات، أم صورة واحدة ثابتة، أم حزمة ملفات مرجعية؟ هذا الاختيار — نص إلى فيديو (T2V)، أو صورة إلى فيديو (I2V)، أو مرجع إلى فيديو (R2V) — يقرّر كم من التحكم تحصل عليه، وإلى أي مدى يبقى موضوعك ثابتًا عبر المقاطع، وكم تكلف المسوّدات تقريبًا. الخطأ يعني غالبًا حرق ائتمانات على توليدات ترميها، ولهذا أرخص فيديو تستطيع صنعه هو الذي تصنعه في الوضع الصحيح من المحاولة الأولى.
إن أردت المفهوم مشروحًا من الصفر — كيف يعمل فعلًا التكييف بالمواد المرجعية — يغطّي دليلنا عن معنى المرجع إلى فيديو تلك الجهة بعمق. هذا المقال جهة قرار الشراء: أي وضع يناسب اللقطة التي في ذهنك، وأي محرّك يناسب الوضع، وكم تتوقع أن تدفع لكل مقطع.
إجابات سريعة
هل المرجع إلى فيديو أغلى من النص إلى فيديو؟ قليلًا، بالطول والدقة نفسيهما، لأن محرّكات R2V تحاسب على مواد الإدخال فوق إعفاء الصور المجانية، والفيديو المرجعي الطويل يتراكم. عمليًا، R2V كثيرًا ما يخرج أرخص لكل مقطع قابل للاستعمال: مخرج T2V بلا ثبات هوية يعني إعادة الرمي حتى يصيب الموضوع، وكل رمية كاملة تكلف ثمن مقطع كامل.
هل أستطيع بدء مشروع بالنص إلى الفيديو ثم تحويل الشخصية نفسها إلى وضع المرجع لاحقًا؟ نعم، وهو طريق شائع: ولّد شخصية تعجبك في تشغيلة نص-إلى-صورة أو T2V، واحفظ أفضل إطار كمرجع للوجه، ثم واصل المشروع في R2V. لا يلزم أن تكون ورقة المراجع مصوّرة — الشخصيات الرقمية تحمل الهوية بالمقدار نفسه.
هل يكتفي المبتدئ بتحويل الصورة إلى فيديو بدل تعلّم المراجع؟ فقط إن كانت كل لقطة تحتاجها هي صورة محددة واحدة تُبعث حيّة كما هي. لحظة تحتاج فيها الموضوع نفسه في مشهد ثانٍ مختلف، يصطدم I2V بجداره — لا يستطيع المتابعة إلا من الإطار المُعطى له. تجهيز ورقة المراجع في R2V دقائق مرة واحدة ويوفر عليك عشرات التوليدات الفاشلة بعدها.
هل ينجح R2V مع المنتجات، أم الوجوه فقط؟ المنتجات هي حيث يسترد تكلفته أسرع. زجاجة أو حذاء رياضي أو نموذج تغليف من زاويتين أو ثلاث كمرجع ينجو من تبديل الخلفيات وتغيّر الإضاءة أفضل مما تنجو معظم الوجوه من انحراف البرومبت، لأن المنتجات لا تعابير فيها يُخطئها النموذج. تصنع الفرق عادةً دستة نسخ إعلانات من بضع صور منتج.
كيف أعرف المحرّك الذي أختار من دون أن أجرب الثلاثة؟ اتبع المهمة: الحوار ومزامنة الشفاه إلى MiniMax H3 Ref2V، والثبات الأطول أو متعدد الشخصيات إلى Wan 3.0 R2V، وحركة الكاميرا العنيفة إلى Seedance 2.0 R2V. إن لم يناسب أحدها بوضوح، فـ Wan 3.0 هو الافتراضي — إنه مولّد R2V المختار أولًا في Moosky لمعظم مهام المرجع.
الوضع الثلاثة، بحسب ما تطلبه منك
النص إلى فيديو يأخذ برومبتًا ولا شيء غيره. تصف المشهد، والنموذج يخترع كل بكسل. أرخص إدخال (لا ملفات تجهّزها، ولا محاسبة مراجع على أي محرّك Moosky) وأكثرها طلاقة، لكنه بلا ذاكرة: ولّد «المرأة نفسها في الثلاثينيات بشعر مجعّد» مرتين تحصل على امرأتين مختلفتين. استعمله حين لا يتكرر الموضوع — لقطات b-roll مجردة، عاصفة فوق مدينة، أجواء لمرة واحدة.
تحويل الصورة إلى فيديو يأخذ صورة ثابتة واحدة ويحرّكها. تصبح الصورة الإطار الأول، فتحصل على هذه التركيبة بالضبط، وهذا الإضاءة، وهذا الخلفية، مجمّدة نقطة انطلاق. وهو الوضع الصائب حين يكون لديك الصورة فعلًا — رندر منتج، فوتوغرافيا، إطار مفتاحي أقرّه مصمم — وتريد أن تتحرك هي ولا شيء غيرها. المقابل: أنت مقيّد لذلك الإطار. حرّك باريستا خلف بارها وكل مقطع هو باريستا خلف بارها.
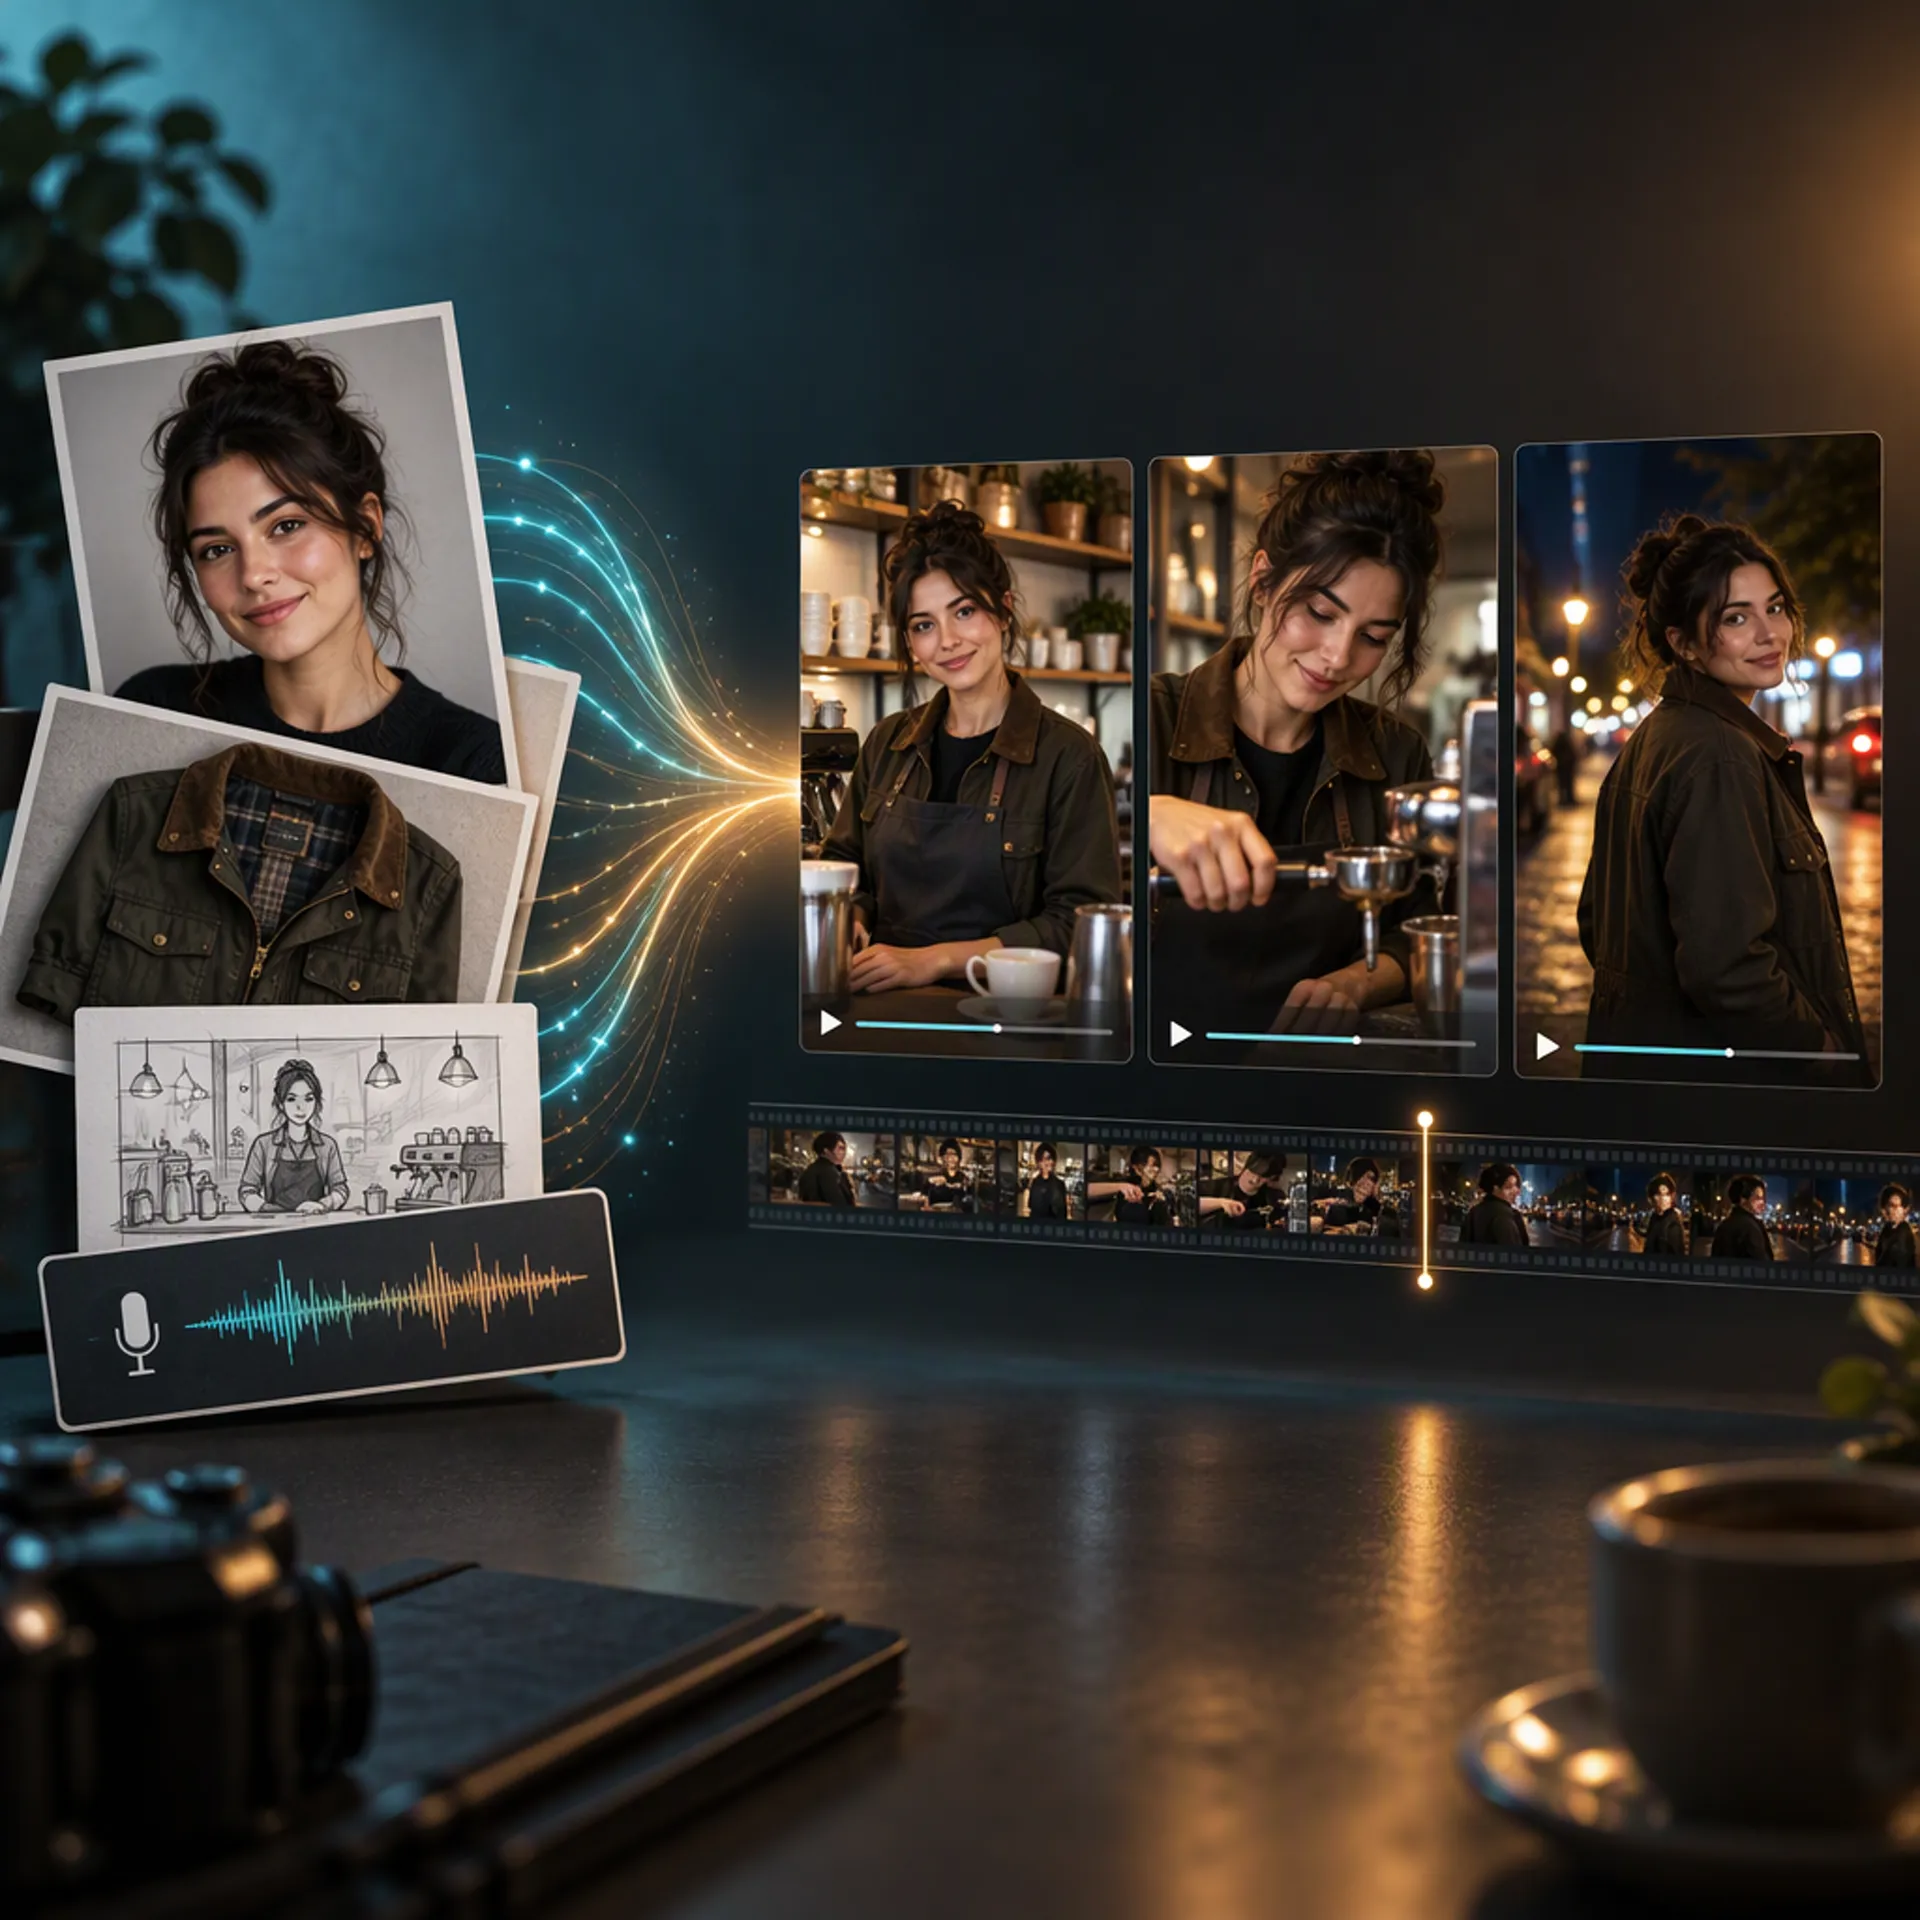
المرجع إلى فيديو يأخذ المراجع ويعاملها كهوية لا تركيبة. ترفع الوجه، واللباس، والمنتج من زاويتين، وربما تسجيل صوت، فيُبقي النموذج من وما ثابتين بينما يغيّر برومبتك بحرية أين وكيف. الشخص نفسه، مشهد جديد، لقطة بعد لقطة. هذا وضع أي عمل مسلسل: شخصيات متكررة، نسخ إعلانات منتج، مشاهد متعددة اللقطات يجب أن تقطع معًا.
ثلاثة أسئلة تحسم وضعك
- هل يجب أن يظهر الموضوع في أكثر من مقطع؟ إن لا، فـ T2V ووفّر وقت التجهيز. إن نعم، تابع.
- هل لديك إطار نهائي واحد يجب أن يتحرك كما هو بالضبط؟ فالـ I2V — الصورة تملك التركيبة، ولن يضاهيها أي وضع مراجع بهذه الدقة.
- الموضوع ثابت والمواقع ليست كذلك؟ هذا هو R2V. ورقة مراجع واحدة، وعدد لا نهائي من الأماكن.
معظم من يبحث عن «فيديو مرجعي» أو «ref2v» عند السؤال الثالث. الخطأ الذي يحرق أكثر الائتمانات هو أن تجيب السؤال الثاني بينما السؤال الحقيقي كان الثالث: تحرّك صورة واحدة معتمدة في I2V، ثم تكتشف أنك تحتاج الوجه نفسه من زاوية مختلفة، ولا تعطيك الصورة وسيلة لطلب ذلك.
أي محرّك، ما إن تكون في R2V
على Moosky تنقسم محرّكات R2V الثلاثة بحسب المهمة، ويسير دليل خطوات MiniMax H3 Ref2V في الأول منها تفصيليًا:
MiniMax H3 Ref2V هو خيار الحوار. أرفق حتى 9 صور و3 مقاطع فيديو و3 ملفات صوتية (12 ملفًا إجمالًا)، فيؤدّي مشهدًا متزامن الشفاه بصوت ستيريو منسجم في التشغيلة نفسها، بـ 11 لغة. تمتد المقاطع من 4 إلى 15 ثانية على 768P أو 2K. إن كانت لقطتك شخصًا يتكلم أمام الكاميرا، فهنا يبدأ الأمر.
Wan 3.0 R2V هو الافتراضي لفعل ثابت الشخصيات. يستقبل أكبر عدد من المراجع (10 صور، 5 مقاطع، 5 مسارات صوتية)، ويعمل حتى 1080P وثلاثين ثانية، ويتعامل مع مشاهد أطول وأكثر حركة مما تسمح به نافذة H3. تعتمد العروض الرسمية على حوار متعدد الشخصيات وثبات الأغراض.
Seedance 2.0 R2V هو خيار الحركة العنيفة للكاميرا — حركة معقدة وفعل سريع — على 480p–1080p (و4K على النموذج القياسي)، من 4 إلى 15 ثانية. يحمل أشد رفضيات سياسة الواقعية الفوتوغرافية للبشر، فضع بديلًا غير فوتوغرافي في الحسبان.
والثلاثة تدور على رصيد الائتمانات نفسه، فلا يكلفك اختيار المحرّك شيئًا إن أعدت النظر فيه بين لقطة وأخرى.
كم يكلّف كل وضع قبل أن تضغط توليد
تسعّر Moosky بمئة ائتمان لكل دولار، بلا اشتراك، ويقتبس المولّد تكلفة مهمتك بالتحديد قبل أن تشغّلها. أبعاد المحاسبة تختلف بما يكفي ليصبح اختيار الوضع جزئيًا خيار ميزانية:
- T2V يحاسب على طول المخرج ودقته فقط. أرضية المسودات.
- I2V يحاسب بالمثل؛ صورة الإدخال مجانية على كل محرّك (هي صورة واحدة).
- R2V يضيف مواد الإدخال إلى الفاتورة. في H3 Ref2V أول 5 صور إدخال مجانية وكل زائد يُحاسب؛ فيديو الإدخال يُحاسب بالثانية على دقة الإخراج التي تختارها (0,08 دولار/ثانية فيديو مرجعي على 768P، و0,13 دولار/ثانية على 2K، بتسعير MiniMax المعروض في اقتباس المولّد). المخرج على 768P يدور حول 10 ائتمانات لكل ثانية مقطع — لقطة من 5 ثوانٍ نحو 50 ائتمانًا، أي نحو خمسين سنتًا.
عادتان تبقيان R2V رخيصًا: أعد استعمال ورقة مراجع واحدة بدل إعادة تجهيز الملفات لكل لقطة، وولّد مسوّداتك على 768P قبل الالتزام برندر نهائي على 2K.
عند مقارنة الأدوات، اشترِ الاقتباس لا العرض الترويجي
كل عروض البائعين تبدو ثابتة — فهم يعرضون أفضل ورقة مراجع عندهم. قبل أن تلتزم بإنفاق على أي منتج R2V، تحقق من آليات الشراء: هل يعرض تكلفة دقيقة لكل مقطع قبل التوليد (Moosky تفعل، في المولّد)، هل يحاسب على صور الإدخال والفيديو المرجعي فوق إعفاء مجاني، هل تثبت الهوية عبر توليدات منفصلة أم داخل المقطع وحسب، وهل يوجد خيار بلا اشتراك كي تختبر سعر شخصية قبل التوسيع بها. على مركز المرجع إلى فيديو تتقاسم المحرّكات الثلاثة رصيد ائتمان ومحفظتين واحدة، ما يجعل الاختبار جنبًا إلى جنب رخيصًا: ولد ورقة مراجعك مرة وشغّل المشهد نفسه على الثلاثة ببضع دولارات.
اليوم الأول: افتح مركز المرجع إلى فيديو، ارفع ورقة — وجه، زاويتان من المنتج، تسجيل صوت — وشغّل المشهد نفسه على محرّكات R2V الثلاثة ببضع دولارات. هذه هي المقارنة التي تقرر، لا العروض.
أبدع مع Moosky AI
حوّل أفكارك إلى أعمال مكتملة
وصول إلى أبرز نماذج الذكاء الاصطناعي وسير العمل الإنتاجي من مساحة عمل واحدة.
جرّب Moosky AIالتعليقات
تُراجع التعليقات قبل نشرها للعامة.
انضم إلى النقاش —سجّل الدخولأوأنشئ حسابًالترك تعليق.
لا توجد تعليقات معتمدة بعد. ابدأ المحادثة.