Guide de terrain Moosky AI
Qu'est-ce qu'une vidéo de référence IA ? Choisir entre R2V, image-vidéo et texte-vidéo
Le guide d'achat de la vidéo de référence IA : comment se distinguent R2V, image-vidéo et texte-vidéo, quand utiliser chacun, et ce que coûte chaque clip.
Sur cette page
Vous avez une idée de clip et une décision à prendre avant de taper un seul prompt : est-ce que le modèle a besoin de mots, d'une photo fixe, ou d'un dossier de fichiers de référence ? Ce choix — text-to-video (T2V), image-to-video (I2V), ou reference-to-video (R2V) — décide de combien de contrôle vous obtenez, de jusqu'où votre sujet reste cohérent d'un clip à l'autre, et à peu près de ce que chaque ébauche coûte. Se tromper veut souvent dire brûler des crédits en générations jetées — c'est pour ça que la vidéo la moins chère que vous puissiez faire est celle que vous faites du premier coup dans le bon mode.
Vous voulez le concept expliqué depuis zéro — comment le conditionnement par références fonctionne réellement — notre guide de ce qu'est reference-to-video couvre ce côté en profondeur. Cet article est le côté décision d'achat : quel mode colle au plan que vous avez en tête, quel moteur colle au mode, et à quoi vous attendre à payer par clip.
Réponses rapides
Le reference-to-video coûte-t-il plus cher que le text-to-video ? Légèrement, à durée et résolution égales, parce que les moteurs R2V facturent la matière d'entrée au-delà de la franchise d'images gratuites et que la vidéo de référence longue s'accumule. En pratique, le R2V revient souvent moins cher par clip utilisable : la sortie zéro-cohérence du T2V oblige à relancer jusqu'à ce que le sujet soit le bon, et chaque relance coûte un clip entier.
Puis-je commencer un projet en texte-vidéo et passer le même personnage en mode référence plus tard ? Oui, et c'est un chemin courant : générez un personnage qui vous plaît dans une passe texte-image ou T2V, sauvegardez le meilleur frame comme référence de visage, et continuez le projet en R2V. La fiche de références n'a pas besoin d'être photographiée — les personnages numériques portent l'identité tout aussi bien.
Un débutant devrait-il juste faire de l'image-vidéo plutôt qu'apprendre les références ? Seulement si chaque plan dont vous avez besoin est une photo précise animée telle quelle. Dès qu'il vous faut le même sujet dans un second scène différente, l'I2V heurte son mur — il ne peut continuer que depuis le frame qu'on lui a donné. La mise en place de la fiche de références du R2V prend quelques minutes une fois et vous épargne des dizaines de générations ratées ensuite.
Le R2V marche-t-il pour des produits, ou seulement des visages ? Les produits sont là où ça rembourse le plus vite. Une bouteille, une sneaker ou une maquette de packaging pris sous deux ou trois angles en références survivent mieux aux changements de fond et de lumière que la plupart des visages ne survivent à la dérive de prompt, parce qu'un produit n'a pas d'expressions que le modèle peut rater. Des équipes produisent régulièrement une douzaine de variantes de pub depuis quelques photos produit.
Comment savoir quel moteur choisir sans les essayer tous ? Suivez le job : dialogue et lip-sync vers MiniMax H3 Ref2V, cohérence longue ou multi-personnages vers Wan 3.0 R2V, mouvement de caméra lourd vers Seedance 2.0 R2V. Si aucun ne colle à l'évidence, Wan 3.0 est le choix par défaut — c'est le composer R2V premier choix de Moosky pour la plupart des jobs avec références.
Les trois modes, facturés selon ce qu'ils exigent de vous
Text-to-video prend un prompt et rien d'autre. Vous décrivez la scène, le modèle invente chaque pixel. C'est l'entrée la moins chère (aucun fichier à préparer, aucune facturation de référence sur aucun moteur Moosky) et la plus libre, mais elle n'a pas de mémoire : générez deux fois « la même femme de trente ans aux cheveux bouclés » et vous obtenez deux femmes différentes. À utiliser quand le sujet ne revient pas — b-roll abstrait, un orage sur une ville, plans d'ambiance one-off.
Image-to-video prend une photo fixe et l'anime. L'image devient le premier cadre, donc vous obtenez exactement cette composition, cette lumière, ce fond, gelés comme point de départ. C'est le bon mode quand vous avez déjà la photo — un rendu produit, une photographie, un key frame qu'un designer a validé — et que vous voulez qu'elle bouge, rien de plus. La contrepartie : vous êtes verrouillé sur ce frame. Animez votre bariste à son comptoir et chaque clip sera votre bariste à son comptoir.
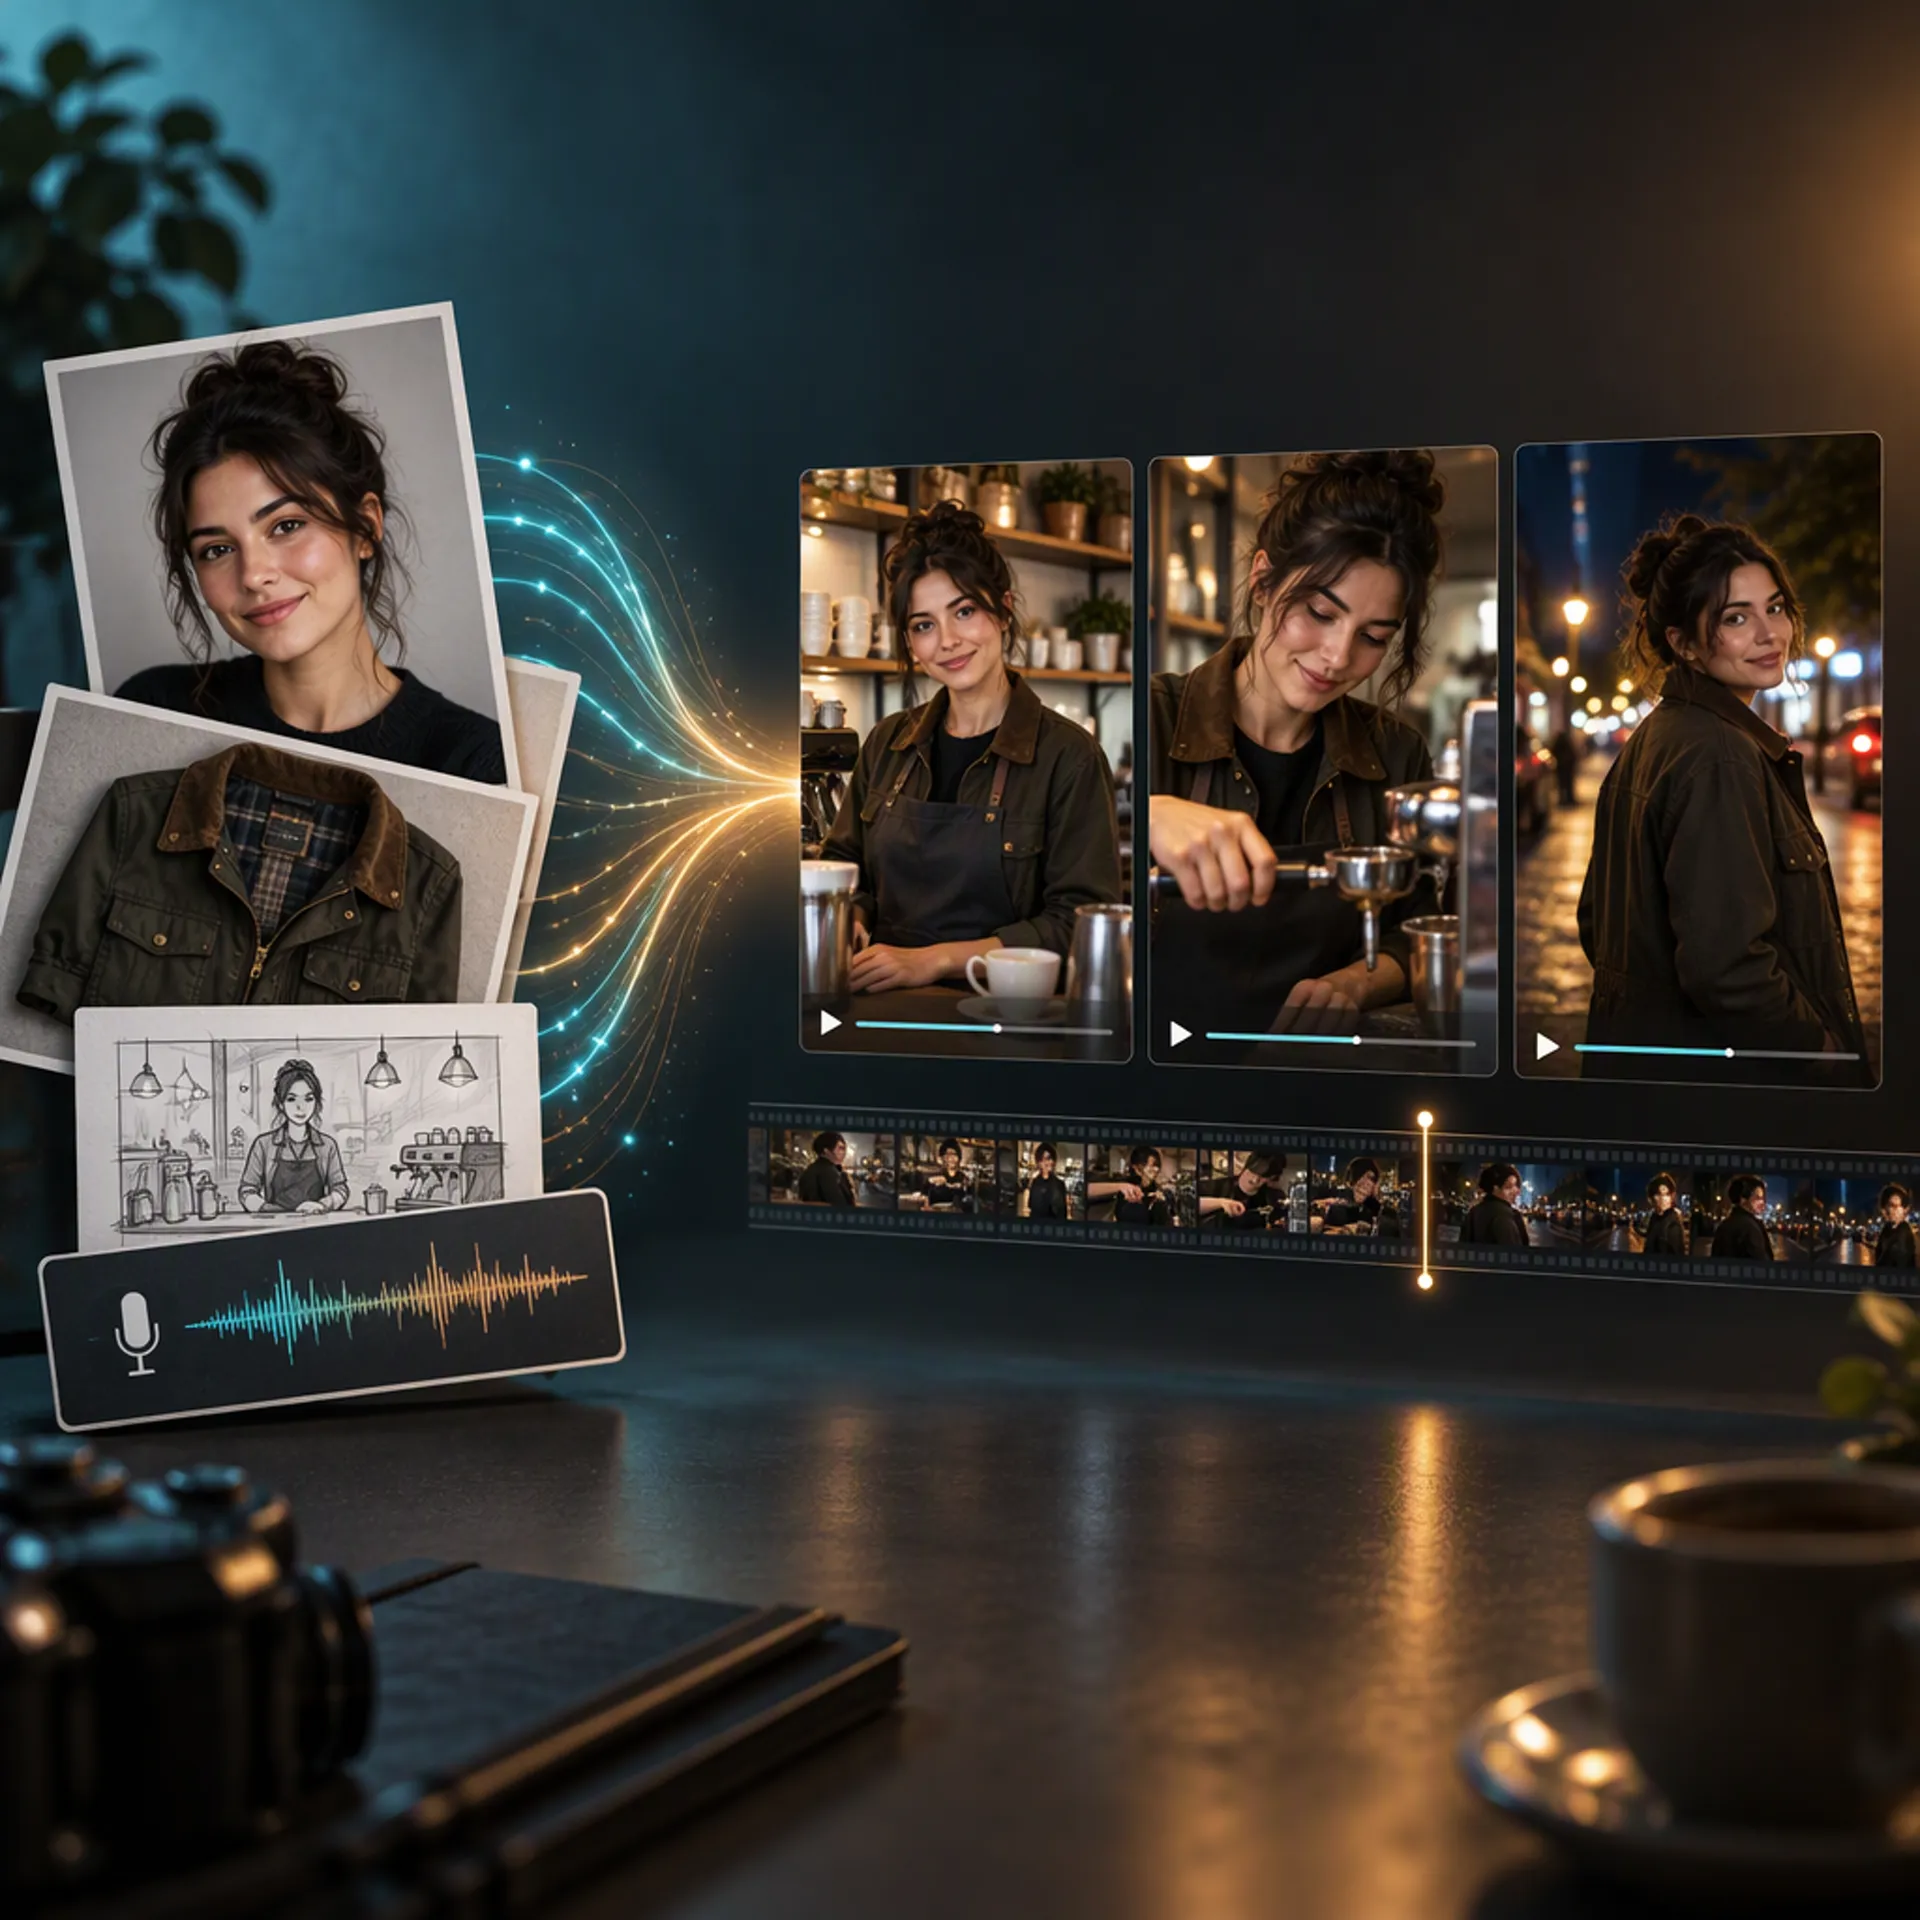
Reference-to-video prend des références et les traite comme identité, pas comme composition. Vous téléversez le visage, le vestiaire, le produit sous deux angles, éventuellement une prise de voix, et le modèle garde qui et quoi fixes pendant que votre prompt change librement où et comment. Même personne, nouvelle scène, prise après prise. C'est le mode de tout ce qui est sérialisé : personnages récurrents, variantes de pub produit, scènes multi-plans qui doivent monter ensemble.
Trois questions qui décident de votre mode
- Le sujet doit-il apparaître dans plus d'un clip ? Si non, T2V et économisez le temps de préparation. Si oui, continuez.
- Avez-vous un frame fini qui doit bouger exactement tel quel ? Alors I2V — la photo possède la composition, et aucun mode référence ne l'atteindra avec cette précision.
- Le sujet est fixe mais pas les scènes ? C'est du R2V. Une fiche de références, un nombre illimité de décors.
La plupart des gens qui cherchent « video de référence » ou « ref2v » sont à la question trois. L'erreur qui gaze le plus de crédits, c'est de répondre à la question deux alors que la vraie question était trois : vous animez une photo validée en I2V, puis vous découvrez qu'il vous faut le même visage sous un autre angle, et la photo ne vous donne aucun moyen de le demander.
Quel moteur, une fois en R2V
Sur Moosky, les trois moteurs R2V se répartissent par job, et le workflow MiniMax H3 Ref2V pas à pas déroule le premier en détail :
MiniMax H3 Ref2V est le choix dialogue. Attachez jusqu'à 9 images, 3 clips vidéo et 3 fichiers audio (12 fichiers au total), et il joue une scène lip-syncée avec son stéréo synchronisé dans la même passe, en 11 langues. Les clips font 4 à 15 secondes en 768P ou 2K. Si votre plan a une personne qui parle face caméra, ça commence ici.
Wan 3.0 R2V est le choix par défaut pour l'action cohérente en personnages. Il prend le plus de références (10 images, 5 vidéos, 5 pistes audio), tourne jusqu'à 1080P et 30 secondes, et gère des scènes plus longues et plus cinétiques que la fenêtre de H3 ne le permet. Les démos officielles misent sur le dialogue multi-personnages et la cohérence des accessoires.
Seedance 2.0 R2V est le choix premium pour le mouvement lourd — caméra complexe, action rapide — en 480p–1080p (4K sur le modèle standard), 4 à 15 secondes. Il porte les rejets de politique photoréaliste-humain les plus stricts, donc gardez un repli non-photoréaliste en tête.
Les trois tournent sur le même solde de crédits, donc le choix du moteur ne coûte rien à reconsidérer entre deux plans.
Ce que chaque mode coûte avant d'appuyer sur générer
Moosky facture 100 crédits par $1, sans abonnement, et le composer cite le coût exact de votre job avant que vous le lanciez. Les dimensions de facturation diffèrent assez pour que le choix du mode soit aussi en partie un choix de budget :
- T2V facture la durée de sortie et la résolution seulement. Le plancher pour les ébauches.
- I2V facture de la même façon ; l'image d'entrée est gratuite sur tous les moteurs (c'est une image).
- R2V ajoute la matière d'entrée à la facture. Sur H3 Ref2V les 5 premières images d'entrée sont gratuites et chacune au-delà est facturée ; la vidéo d'entrée est facturée à la seconde à votre résolution de sortie ($0.08/s de vidéo de référence en 768P, $0.13/s en 2K, tarifé par MiniMax et visible dans le devis du composer). La sortie en 768P tourne autour de 10 crédits par seconde de clip — un take de 5 secondes fait environ 50 crédits, environ cinquante centimes.
Deux habitudes gardent le R2V bon marché : réutiliser une seule fiche de références au lieu de re-curate des fichiers à chaque plan, et ébaucher en 768P avant d'engager un rendu final en 2K.
En comparant les outils, achetez le devis, pas la démo
Toutes les démos vendeur paraissent cohérentes — elles montrent leur meilleure fiche de références. Avant d'engager une dépense sur un produit R2V, vérifiez la mécanique d'achat : affiche-t-il un coût exact par clip avant de générer (Moosky le fait, dans le composer), facture-t-il les images d'entrée et la vidéo de référence au-delà d'une franchise gratuite, l'identité tient-elle entre générations séparées ou seulement dans un seul clip, et existe-t-il une option sans abonnement pour tester un personnage au prix avant de le passer à l'échelle. Sur le hub reference-to-video les trois moteurs partagent un solde de crédits et un portefeuille, ce qui rend le test côte à côte bon marché : générez votre fiche de références une fois et lancez la même scène sur les trois pour quelques dollars.
Le geste du premier jour : ouvrez le hub reference-to-video, chargez une fiche — un visage, deux angles du produit, une prise de voix — et lancez la même scène sur les trois moteurs R2V pour quelques dollars. C'est le comparatif qui décide, pas les démos.
Créez avec Moosky AI
Transformez vos idées en productions achevées
Accédez aux meilleurs modèles d’IA et flux de production depuis un seul espace de travail.
Essayer Moosky AICommentaires
Les commentaires sont vérifiés avant leur publication.
Rejoignez la discussion —connectez-vousoucréer un comptepour laisser un commentaire.
Aucun commentaire approuvé pour le moment. Lancez la conversation.