Panduan lapangan Moosky AI
Apa Itu Video Referensi AI? Memilih antara R2V, Image-to-Video, dan Text-to-Video
Panduan pembeli video referensi AI: bagaimana R2V, image-to-video, dan text-to-video berbeda, kapan memakai masing-masing, dan berapa biaya tiap klip.
Di halaman ini
Anda punya ide klip dan satu keputusan sebelum mengetik prompt pertama: apakah model butuh kata-kata, satu foto diam, atau satu set berkas referensi? Pilihan itulah — text-to-video (T2V), image-to-video (I2V), atau reference-to-video (R2V) — yang menentukan seberapa besar kendali yang Anda dapat, seberapa konsisten subjek Anda bertahan antar klip, dan kira-kira berapa harga tiap draft. Salah pilih biasanya berarti membakar kredit untuk generasi yang Anda buang, dan itulah kenapa video termurah yang bisa Anda buat adalah yang Anda buat di mode yang benar sejak percobaan pertama.
Kalau Anda ingin konsepnya dijelaskan dari nol — bagaimana conditioning pada referensi sebenarnya bekerja — panduan kami tentang apa itu reference-to-video membahas sisi itu secara dalam. Artikel ini sisi keputusan pembeli: mode mana yang cocok dengan shot yang Anda incar, mesin mana yang cocok dengan mode-nya, dan berapa yang perlu Anda bayar per klip.
Jawaban cepat
Apakah reference-to-video lebih mahal dari text-to-video? Sedikit, pada panjang dan resolusi yang sama, karena mesin R2V menagih materi input di luar jatah gambar gratis dan video referensi yang panjang terus menumpuk. Dalam praktik, R2V justru sering lebih murah per klip yang terpakai: keluaran T2V tanpa konsistensi berarti mengulang undian sampai subjeknya cocok, dan tiap undian ulang berharga sepotong klip penuh.
Bisakah saya memulai proyek di text-to-video lalu memindahkan karakter yang sama ke mode referensi belakangan? Bisa, dan ini jalur yang umum: generate karakter yang Anda suka di pass text-to-image atau T2V, simpan frame terbaik sebagai referensi wajah, lalu lanjutkan proyek di R2V. Lembar referensi tidak harus difoto — karakter digital membawa identitas sama baiknya.
Pemula sebaiknya pakai image-to-video saja daripada belajar referensi? Hanya kalau setiap shot yang Anda butuhkan adalah satu foto spesifik yang dihidupkan apa adanya. Begitu Anda butuh subjek yang sama di adegan kedua yang berbeda, I2V menabrak dindingnya — ia hanya bisa melanjutkan dari frame yang diberikan. Setup lembar referensi R2V beberapa menit sekali dan menghemat puluhan generasi gagal setelahnya.
Apakah R2V jalan untuk produk, atau cuma wajah? Produk justru tempat modalnya paling cepat kembali. Botol, sneakers, atau mockup kemasan dari dua-tiga sudut sebagai referensi lebih selamat dari ganti latar dan ubah pencahayaan dibanding kebanyakan wajah selamat dari drift prompt, karena produk tidak punya ekspresi yang bisa salah dimengerti model. Tim rutin memproduksi selusin varian iklan dari beberapa foto produk.
Bagaimana tahu mesin mana yang dipilih tanpa mencoba ketiganya? Ikuti pekerjaannya: dialog dan lip-sync ke MiniMax H3 Ref2V, konsistensi lebih panjang atau multi-karakter ke Wan 3.0 R2V, pergerakan kamera berat ke Seedance 2.0 R2V. Kalau tidak ada yang jelas cocok, Wan 3.0 adalah default — ia composer R2V pilihan pertama Moosky untuk kebanyakan job referensi.
Tiga mode, ditagih berdasarkan tuntutannya pada Anda
Text-to-video mengambil prompt dan tidak ada yang lain. Anda mendeskripsikan adegannya, modelnya mengarang tiap piksel. Ini input paling murah (tidak ada berkas untuk disiapkan, tidak ada penagihan referensi di semua mesin Moosky) dan paling bebas, tapi tidak punya memori: generate dua kali "wanita tiga puluhan berambut keriting yang sama" dan Anda dapat dua wanita berbeda. Pakai saat subjeknya tidak muncul berulang — b-roll abstrak, badai di atas kota, shot atmosfer sekali jadi.
Image-to-video mengambil satu foto diam dan menganimasikannya. Gambar itu menjadi frame pertama, jadi Anda dapat persis komposisi itu, pencahayaan itu, latar itu, dibekukan sebagai titik awal. Ini mode yang tepat ketika fotonya sudah ada — render produk, foto, key frame yang disetujui desainer — dan Anda ingin foto itu bergerak, bukan yang lain. Konsekuensinya: Anda terkunci pada frame itu. Animasikan barista Anda di konternya dan tiap klip adalah barista Anda di konternya.
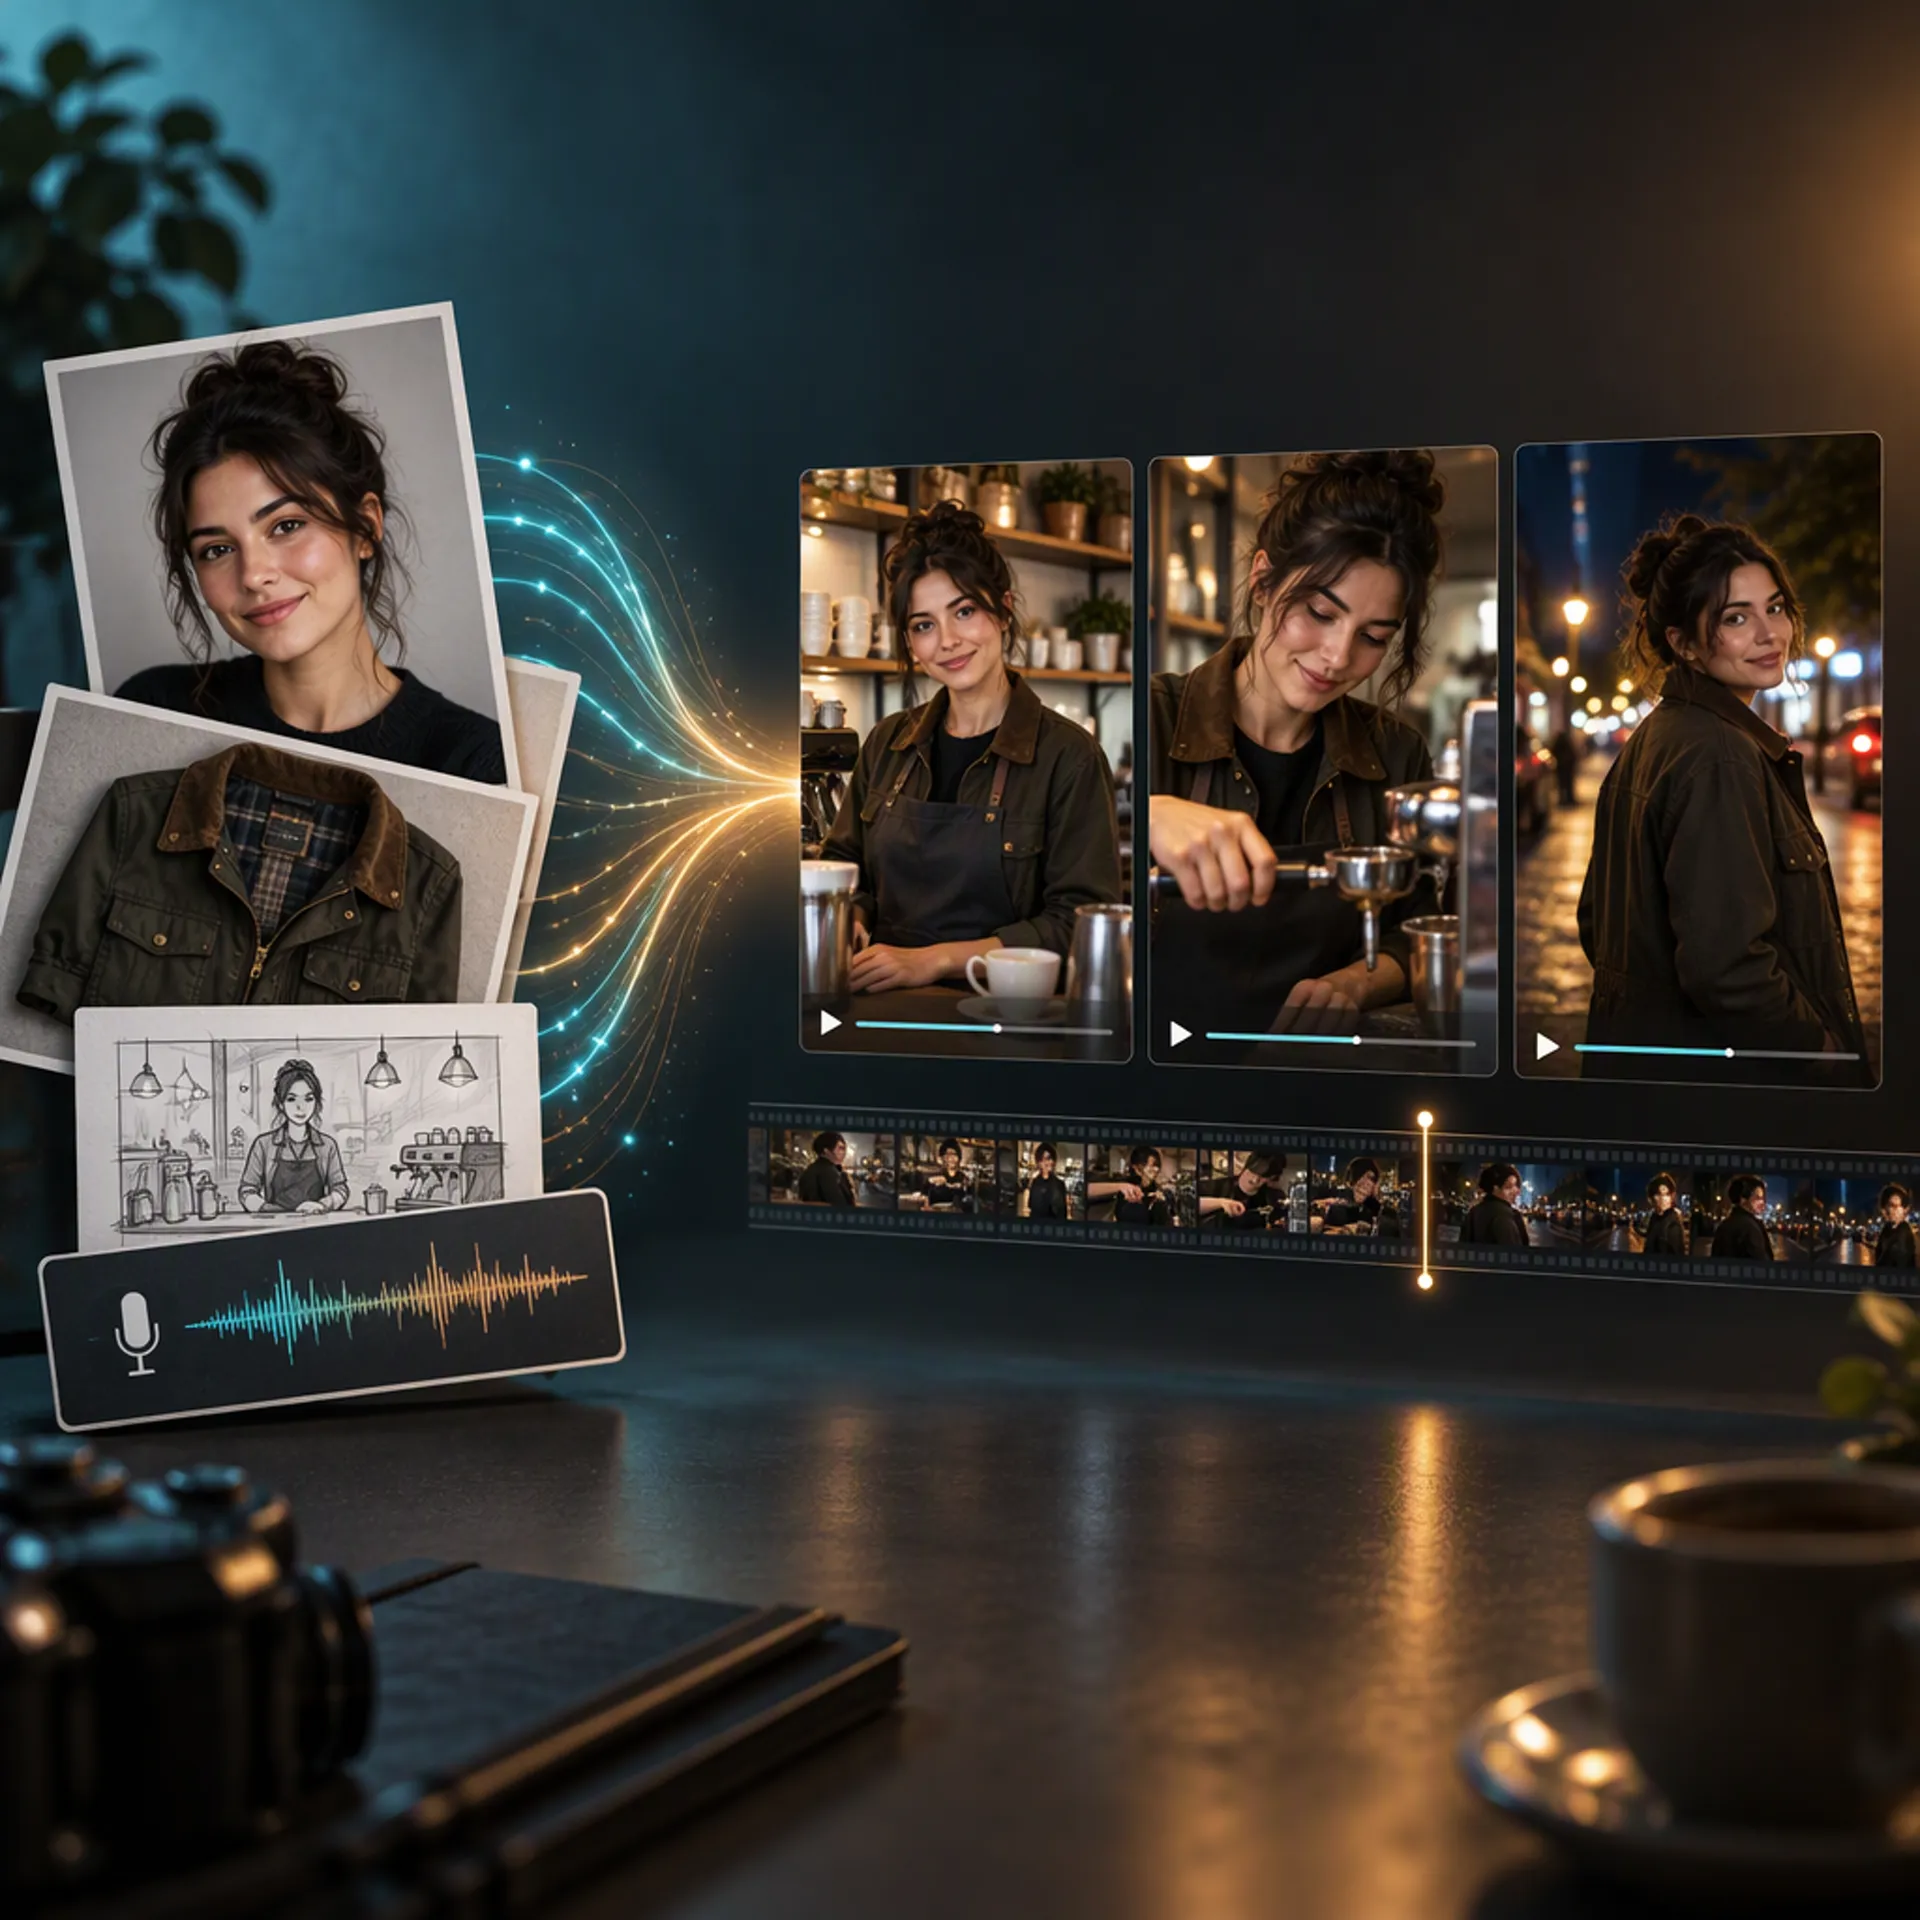
Reference-to-video mengambil referensi dan memperlakukannya sebagai identitas, bukan komposisi. Anda mengunggah wajah, wardrobe, produk dari dua sudut, mungkin satu take suara, dan model menahan siapa dan apa tetap tetap sementara prompt Anda bebas mengubah di mana dan bagaimana. Orang yang sama, adegan baru, take demi take. Ini mode untuk semua yang terserialisasi: karakter berulang, varian iklan produk, adegan multi-shot yang harus tersambung saat diedit.
Tiga pertanyaan yang menentukan mode Anda
- Apakah subjeknya harus muncul di lebih dari satu klip? Kalau tidak, pakai T2V dan hemat waktu setup. Kalau ya, lanjut baca.
- Apakah Anda punya satu frame final yang harus bergerak persis apa adanya? Maka I2V — foto itu memegang komposisi, dan tidak ada mode referensi yang menyamainya sepresisi itu.
- Subjeknya tetap tapi adegannya tidak? Itu R2V. Satu lembar referensi, latar tak terbatas.
Kebanyakan orang yang mencari "video referensi" atau "ref2v" ada di pertanyaan tiga. Kesalahan yang paling membakar kredit adalah menjawab pertanyaan dua padahal pertanyaan sesungguhnya adalah tiga: Anda menganimasikan satu foto yang sudah disetujui di I2V, lalu menemukan bahwa Anda butuh wajah yang sama dari sudut berbeda, dan foto itu tidak memberi jalan untuk memintanya.
Mesin mana, begitu Anda masuk R2V
Di Moosky tiga mesin R2V berbagi menurut pekerjaan, dan panduan langkah MiniMax H3 Ref2V berjalan detail di yang pertama:
MiniMax H3 Ref2V adalah pilihan dialog. Lampirkan sampai 9 gambar, 3 klip video, dan 3 berkas audio (12 berkas total), dan ia memainkan satu scene lip-sync dengan suara stereo tersinkron di pass yang sama, dalam 11 bahasa. Klip berjalan 4–15 detik di 768P atau 2K. Kalau shot Anda punya orang bicara ke kamera, mulai dari sini.
Wan 3.0 R2V adalah default untuk aksi yang konsisten karakter. Ia menerima referensi terbanyak (10 gambar, 5 video, 5 audio), jalan sampai 1080P dan 30 detik, dan menangani adegan yang lebih panjang dan lebih kinetik daripada jendela H3 izinkan. Demo resminya bertumpu pada dialog multi-karakter dan konsistensi properti.
Seedance 2.0 R2V adalah pilihan premium untuk gerak berat — pergerakan kamera kompleks dan aksi cepat — di 480p–1080p (4K di model standar), 4–15 detik. Ia memikul penolakan kebijakan foto-realistis-manusia paling ketat, jadi siapkan fallback non-fotorealistis.
Ketiganya jalan di saldo kredit yang sama, jadi pilihan mesin tidak biaya apa pun untuk ditinjau ulang antar shot.
Harga tiap mode sebelum Anda menekan generate
Moosky menagih 100 kredit per $1, tanpa langganan, dan composer mengutip biaya persis job Anda sebelum Anda menjalankannya. Dimensi penagihannya cukup berbeda sehingga pilihan mode sebagian adalah pilihan anggaran:
- T2V menagih panjang keluaran dan resolusi saja. Lantai untuk draft.
- I2V menagih dengan cara yang sama; gambar inputnya gratis di semua mesin (itu cuma satu gambar).
- R2V menambahkan materi input ke tagihan. Di H3 Ref2V, 5 gambar input pertama gratis dan sisanya ditagih; video input ditagih per detik di resolusi keluaran Anda ($0.08/s video referensi di 768P, $0.13/s di 2K, sesuai harga MiniMax dan tampil di kutipan composer). Keluaran di 768P sekitar 10 kredit per detik klip — take 5 detik kira-kira 50 kredit, sekitar lima puluh sen.
Dua kebiasaan menjaga R2V tetap murah: pakai ulang satu lembar referensi alih-alih mengkurasi ulang berkas tiap shot, dan draft di 768P sebelum berkomitmen render final di 2K.
Saat membandingkan tools, belilah kutipannya, bukan demonya
Semua demo vendor terlihat konsisten — mereka menunjukkan lembar referensi terbaik mereka. Sebelum berkomitmen belanja ke produk R2V mana pun, cek mekanika pembeliannya: apakah ia menampilkan biaya persis per klip sebelum Anda generate (Moosky ya, di composer), apakah ia menagih gambar input dan video referensi di luar jatah gratis, apakah identitas bertahan antar generasi terpisah atau hanya di dalam satu klip, dan apakah ada opsi tanpa langganan sehingga Anda bisa uji harga satu karakter sebelum menskalakannya. Di hub reference-to-video tiga mesin berbagi satu saldo kredit dan satu wallet, yang membuat uji berdampingan jadi murah: generate lembar referensi Anda sekali dan jalankan adegan yang sama di ketiganya untuk beberapa dolar.
Gerakan hari pertama: buka hub reference-to-video, muat satu lembar — wajah, dua sudut produk, satu take suara — dan jalankan adegan yang sama di tiga mesin R2V untuk beberapa dolar. Itulah perbandingan yang memutuskan, bukan demo.
Berkarya dengan Moosky AI
Ubah ide menjadi produksi yang siap tayang
Akses model AI terkemuka dan alur kerja produksi dalam satu ruang kerja.
Coba Moosky AIKomentar
Komentar ditinjau sebelum ditampilkan secara publik.
Ikut berdiskusi —masukataubuat akununtuk meninggalkan komentar.
Belum ada komentar yang disetujui. Mulai diskusi.